LOCAL LLM FIELD GUIDE
Speculative Decoding และ Attention Backend: เร็วขึ้นเมื่อเงื่อนไขตรง
Speculative Decoding เปรียบเหมือนการจับคู่ ศาสตราจารย์อัจฉริยะ (Target Model) กับ ผู้ช่วยฝึกงานหัวไว (Draft Model) ให้ผู้ช่วยช่วยเดาคำล่วงหน้า แล้วศาสตราจารย์ตรวจพร้อมกันทีเดียว จะช่วยให้ความเร็วพุ่งขึ้นอย่างมากเมื่อผู้ช่วยเดาถูกเยอะ (Acceptance Rate สูง) ส่วน Attention Backend คือสูตรลัดคณิตศาสตร์ที่ช่วยให้ชิป GPU คำนวณความสัมพันธ์ของคำได้เร็วขึ้นโดยไม่ติดคอขวดแรม
VERIFY BEFORE YOU TRUST
draft เร็วขึ้นได้เมื่อ target รับ token ที่ draft มา
- วัด baseline: TTFT, ITL, output tok/s
- เปิด spec และดู acceptance rate/length
- เทียบ p95 และ cost บน traffic เดียวกัน
ใช้กับงานจริง
เปิด feature แล้ววัดผลเป็นลำดับ
Speculative decoding ให้ draft เสนอ token แล้ว target ตรวจ ผลดีเกิดเมื่อ token ที่ draft เสนอถูกยอมรับมากพอที่จะคุ้มกับงานเพิ่ม
Attention backend เป็นเส้นทาง kernel และ memory access ความเข้ากันได้ขึ้นกับ model, GPU, runtime release, context และ KV dtype
| สัญญาณ | ค่าที่ดี | สัญญาณให้หยุด |
|---|---|---|
| acceptance rate หรือ length | draft ที่ยอมรับต่อเนื่อง | ยอมรับน้อยจน overhead เพิ่ม |
| TTFT | ไม่แย่ลงจนผู้ใช้รู้สึกได้ | first token ช้ากว่า baseline |
| ITL และ output tok/s | decode ดีขึ้นใน workload เดิม | เร็วเฉพาะ short prompt |
| p95 และ peak memory | ยังอยู่ใน SLO และ headroom | tail แย่ลงหรือใกล้ OOM |
ลำดับ benchmark ที่ควรทำ
- วัด baseline โดยไม่เปิด spec decode
- เปิด method ที่ runtime และ model รองรับ
- ดู acceptance, TTFT, ITL, tok/s, p95 และ peak memory
- เทียบ prompt, context และ concurrency ชุดเดิม
- เก็บ feature เฉพาะเมื่อผลดีคงอยู่
method = MTP
working_context = 32768
concurrency = 4
measure = TTFT, ITL, output_tok_s, p95, peak_memory
กลไก speculative decoding
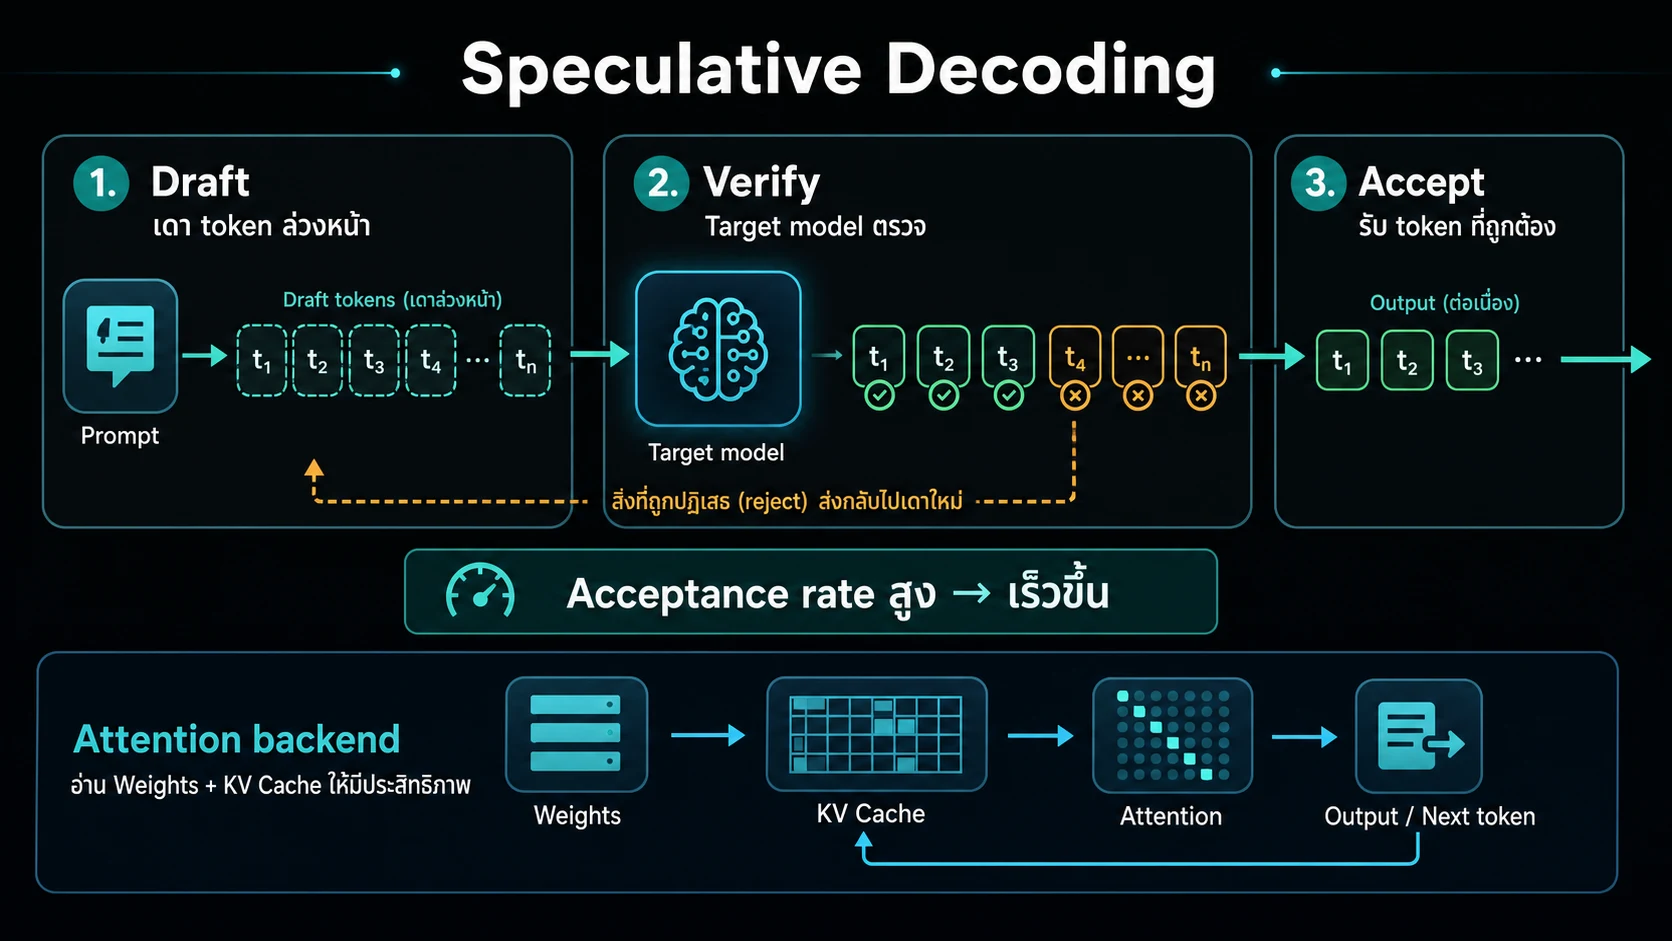
โดยปกติ โมเดล LLM จะสร้างคำตอบทีละคำ (Autoregressive Generation) ซึ่งในแต่ละคำต้องโหลดน้ำหนักสมองทั้งหมดซ้ำแล้วซ้ำเล่า
Speculative Decoding เข้ามาเปลี่ยนกระบวนการนี้ด้วยการจับคู่การทำงาน:
- ตัวเดาคำล่วงหน้า (Draft Method): ใช้โมเดลตัวเล็ก (Draft Model), ระบบ Multi-Token Prediction (MTP) ที่ฝังในตัวโมเดล, หรือตาราง n-gram เพื่อช่วยทายคำล่วงหน้า 3-5 Token อย่างรวดเร็ว
- ตัวตรวจความถูกต้อง (Target Model): โมเดลตัวจริงจะกวาดสายตาตรวจ Token ทั้งหมดที่ถูกเดาขึ้นมาพร้อมกันในรอบการคำนวณเดียว (Parallel Verification)
- ผลลัพธ์ความเร็ว: หากโมเดลตัวจริงเห็นชอบและยอมรับ (Accept) Token ที่เดามา 3 ตัว ระบบจะได้ข้อความออกมา 3 คำในเวลาของการก้าวเท้าเพียงรอบเดียว! ช่วยดันความเร็ว Decode tok/s ให้สูงขึ้น 1.5x-2.5x ทันที
ข้อสำคัญคือ: ต้องวัดอัตราการยอมรับ (Acceptance Rate หรือ Acceptance Length) ควบคู่กับ Latency เสมอ เพราะหากเดาผิดบ่อย ภาระในการตรวจและโยนทิ้งจะทำให้ระบบช้าลงกว่าเดิม
อย่าดูความเร็วเฉลี่ยอย่างเดียว
แม้ว่า Speculative Decoding จะช่วยเพิ่ม Throughput รวมได้ดีในงานทั่วไป แต่ประสิทธิภาพจริงจะขึ้นอยู่กับลักษณะของงานและเงื่อนไขของระบบ:
- งานที่คาดเดาง่าย (High Acceptance): เช่น โค้ดที่มี Syntax ตายตัว, ภาษาที่เป็นทางการ, หรือ Template ข้อความซ้ำๆ งานเหล่านี้ตัวเดาจะทายถูกเกือบหมด ทำให้สปีดพุ่งสูงมาก
- งานที่ซับซ้อน (Low Acceptance): เช่น การคิดเลขคณิตศาสตร์ยากๆ, การแต่งนิยายสร้างสรรค์, หรือการตั้งค่าสุ่มคำ (Temperature / Top-P) ที่กว้างมาก ตัวเดาจะทายผิดบ่อย ทำให้แทบไม่ได้ประโยชน์จาก Speculation
- ตัวชี้วัดที่ต้องตรวจ: ตรวจเช็กทั้งเวลาเริ่มคำแรก (TTFT), ความกระตุกของจังหวะคำ (ITL), และค่าหางยาว (p95/p99 Latency) เพื่อให้มั่นใจว่าการเปิด Speculation ไม่ได้ทำให้ประสบการณ์ใช้งานสะดุด
Attention backend
Attention คือหัวใจของโมเดล Transformer ที่ทำหน้าที่เชื่อมโยงความสัมพันธ์ของทุกคำในประโยค แต่ต้องแลกด้วยการคำนวณและขนาดเมมโมรีมหาศาลที่ขยายตัวตามความยาว Context
Attention Backend จึงถูกพัฒนาขึ้นมาเพื่อเป็นสูตรลัดคณิตศาสตร์ระดับฮาร์ดแวร์:
- FlashAttention & FlashInfer: จัดโครงสร้างการคำนวณใหม่ให้อยู่บน SRAM (แคชความเร็วสูงพิเศษบนชิป GPU) ช่วยลดการส่งถ่ายข้อมูลข้ามไปยัง VRAM หลักได้อย่างมหาศาล ทำให้การอ่าน Prompt ยาวๆ เร็วขึ้นและประหยัดแรม
- PagedAttention: จัดสรรหน่วยความจำ KV Cache เป็นบล็อกๆ คล้าย Virtual Memory ของระบบปฏิบัติการ ป้องกันการจองแรมเกินจริง
- ข้อจำกัดความเข้ากันได้: Attention Backend ไม่ใช่สวิตช์เปิดปิดสากล แต่ขึ้นอยู่กับสถาปัตยกรรม GPU (CUDA / ROCm / Metal), ชนิดตัวเลขของ KV Cache (FP16, BF16, FP8) และเวอร์ชันของ Serving Framework
วิธีเลือก
แนวทางการเลือกและปรับแต่งอย่างเป็นระบบ:
- เริ่มต้นจากค่าแนะนำ: ใช้ Attention Backend มาตรฐานที่ Serving Framework ของคุณแนะนำและรองรับประเภท KV Quantization ที่คุณเลือกใช้
- วัดผล Baseline: ทำการทดสอบวัดค่า TTFT, Decode tok/s และ Peak Memory ในสภาวะปกติก่อนเปิดฟีเจอร์ขั้นสูง
- ทดสอบ Speculative Decoding: เปิดใช้งานเมื่อโมเดลและ Runtime มีเส้นทางรองรับอย่างเป็นทางการ และทดสอบกับชุดคำถามจริงของระบบ
- ปิดฟีเจอร์เมื่อไม่คุ้ม: หากเปิดใช้งานแล้วพบว่า Acceptance Rate ต่ำ, p95 Latency แย่ลง หรือมีความเสี่ยงจะชนเพดานแรม OOM ให้ปิดฟีเจอร์นี้ทิ้ง เพื่อรักษาความเรียบง่ายและความเสถียรของระบบ
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ