LOCAL LLM FIELD GUIDE
เลือก Hardware สำหรับ Local LLM จากงาน ไม่ใช่แค่ชื่อ GPU
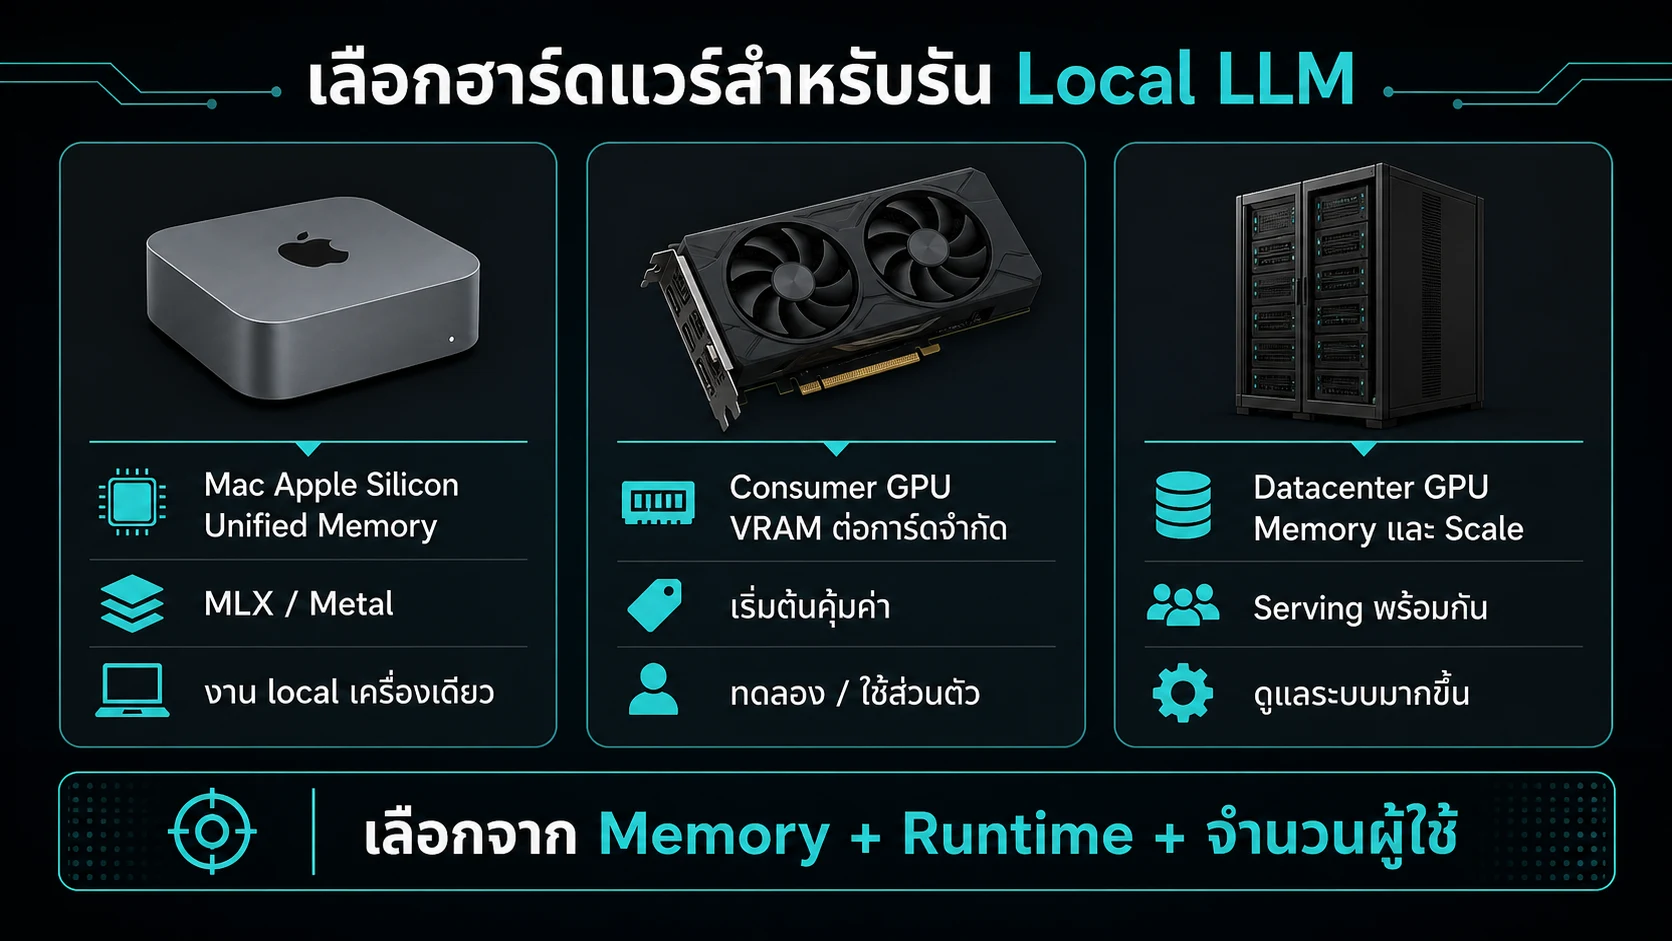
คำถามยอดฮิตว่า ซื้อการ์ดจออะไรดีสำหรับรัน LLM? ไม่สามารถตอบได้ด้วยชื่อรุ่น GPU เพียงอย่างเดียว การเลือกฮาร์ดแวร์ที่ถูกต้อง ต้องเริ่มจากการปักป้ายก่อนว่าคุณต้องการรันโมเดลอะไร, ใช้ Framework ไหน, ต้องรับ Concurrency เท่าไหร่, และมีงบประมาณกี่บาท Mac Apple Silicon เหมาะเป็นเครื่องทำงานส่วนตัวที่รันโมเดลใหญ่ได้ในเครื่องเดียว, NVIDIA คือมาตรฐานสูงสุดสำหรับ Production Server ที่มี Ecosystem แน่นที่สุด, ส่วน AMD ให้คุ้มค่าเรื่อง VRAM ต่อราคา แต่นักพัฒนาต้องตรวจเช็ก Support Matrix ของ ROCm ให้ละเอียด
เลือกจากข้อจำกัด
Tier ไม่ใช่ ranking: เป็น operating model คนละแบบ
 AppleMLX, Metal และ unified memory สำหรับเครื่องทำงานประจำวัน
 NVIDIACUDA, TensorRT-LLM และ ecosystem server ที่กว้าง
 AMDROCm, HIP และเส้นทาง Instinct หรือ RDNA ที่ต้องตรวจ matrix
ใช้กับงานจริง
เลือกเครื่องจากเส้นทาง deploy
เริ่มจาก runtime และ artifact ที่ต้องใช้ เพราะสองอย่างนี้กำหนด GPU path ก่อนราคา จากนั้นดู memory ที่ต้องจอง, bandwidth, และภาระดูแลระบบ
การ์ดที่มี VRAM มากไม่รับประกันว่า workflow จะง่ายกว่า ให้เทียบ model, context และจำนวน request ที่ต้องรองรับกับทางเลือกจริง
| ทางเลือก | เริ่มดูจาก | ตรวจเพิ่ม |
|---|---|---|
| Mac Apple Silicon | MLX หรือ GGUF บน Metal | unified memory, conversion path, local workflow |
| NVIDIA | CUDA runtime และ kernel ที่รองรับ | VRAM, bandwidth, driver, serving topology |
| AMD | ROCm และ HIP support ของ runtime | รุ่น GPU, kernel path, artifact support |
คำถามก่อนซื้อหรือเช่า
- model และ quant ที่ต้องรันคืออะไร
- working context และ sequence พร้อมกันกี่อัน
- ต้องการ TTFT, per-user tok/s หรือ aggregate throughput
- ทีมดูแล Linux, CUDA หรือ ROCm ได้ระดับใด
- ต้องใช้ card เดียว, replica หรือ tensor parallel
hardware = <device>
framework = <runtime>
model = <checkpoint>
working_context = <tokens>
batch = <concurrent sequences>
Mac Apple Silicon: เครื่องทำงานประจำวันและ local LLM
สถาปัตยกรรม Unified Memory Architecture (UMA) ของ Mac Apple Silicon (M2/M3/M4 Series) ได้สร้างจุดเปลี่ยนสำคัญให้วงการ Local LLM ด้วยการให้ CPU, GPU และ Neural Engine แชร์แรมก้อนเดียวกันทั้งหมด!
- จุดเด่น: สามารถสั่งซื้อ Mac Studio หรือ MacBook Pro ที่มี RAM สูงถึง 64 GB, 96 GB, 128 GB หรือ 192 GB เพื่อรันโมเดลระดับ 70B หรือ 120B (ผ่าน GGUF Q4 หรือ MLX) ได้อย่างสบายๆ บนคอมพิวเตอร์เครื่องเดียว โดยไม่ต้องต่อการ์ดจอหลายใบให้ยุ่งยาก แถมยังใช้เป็นเครื่องทำงานพัฒนาซอฟต์แวร์ ตัดต่อ หรือเอกสารได้พร้อมกัน
- ข้อจำกัด: แรม UMA นั้นถูกแชร์ร่วมกับระบบปฏิบัติการ macOS และโปรแกรมอื่นๆ ในเครื่อง, ไม่สามารถถอดอัปเกรด RAM เพิ่มทีหลังได้, และที่สำคัญคือ Memory Bandwidth (เช่น M4 Max ที่ 410-546 GB/s หรือ M3 Ultra ที่ 819 GB/s) ยังคงต่ำกว่าการ์ดจอระดับ High-end GPU Server สถาปัตยกรรม HBM3 (2,000-3,000+ GB/s) ดังนั้น Mac จึงเหมาะมากสำหรับ Personal Workstation หรือ Local Development แต่ไม่ใช่ทางเลือกหลักสำหรับการทำ High-Throughput Production Serving
Mac กับ vLLM: ไม่ได้เป็นศูนย์ แต่ไม่ใช่ CUDA parity
ปัจจุบันชุมชนนักพัฒนาได้สร้าง vLLM-Metal ซึ่งเป็น Hardware Plugin สำหรับ vLLM ที่ดึงเอา MLX Backend มาเปิดให้บริการ OpenAI-Compatible HTTP Server บนเครื่อง Mac ได้สำเร็จ
ดังนั้น จึงไม่ถูกต้องที่จะบอกว่า Mac รัน vLLM ไม่ได้เลย แต่ข้อควรระวังระดับสำคัญคือ ความสามารถ (Feature Support) ของ vLLM-Metal ยังขึ้นอยู่กับสถาปัตยกรรมโมเดลแต่ละตัว และฟีเจอร์เกรดเซิร์ฟเวอร์หลายอย่างยังถูกปฏิเสธหรือไม่ได้รับการทดสอบ เช่น Tensor Parallelism ข้ามการ์ด, Speculative Decoding บางรูปแบบ, LoRA Serving, Vision Language Models (VLM) บางประเภท, และ MoE Shape ซับซ้อน
สำหรับสายสเกลระบบ Production Fleet อย่าออกแบบสถาปัตยกรรมโดยอิงฟีเจอร์ CUDA ของ vLLM แล้วคาดหวังว่าจะได้ประสิทธิภาพและฟีเจอร์เท่ากันเป๊ะบน Mac Metal!
NVIDIA: ecosystem ที่กว้างที่สุดสำหรับ server inference
แพลตฟอร์ม NVIDIA CUDA ยังคงครองตำแหน่งมาตรฐานอันดับหนึ่ง (Gold Standard) สำหรับการทำ Server Inference ด้วย Ecosystem ที่กว้างขวางและเสถียรที่สุดในโลก
- ความสมบูรณ์ของ Software Stack: ไม่ว่าจะเป็น vLLM, SGLang, TensorRT-LLM, FlashAttention-3, ModelOpt หรือ profiling tools ต่างๆ ล้วนได้รับการพัฒนาและทดสอบบน CUDA เป็นด่านแรกเสมอ
- Hardware Generations & Precision Paths:
- Blackwell Generation (RTX 5090, B200, DGX GB300): มาพร้อม FP4 Tensor Cores รองรับ NVFP4 / modelopt_fp4 และ Native FP4 Execution อย่างเต็มรูปแบบ ดันความเร็ว Decode ทะลุขีดจำกัดเดิม
- Ada Lovelace & Hopper (RTX 4090, L40S, H100): รองรับ FP8 Execution (E4M3 / E5M2) ทั้งฝั่ง Weights และ KV Cache ช่วยให้บีบอัดแรมลงครึ่งหนึ่งโดยสปีดไม่ตก
- Datacenter Interconnect: การ์ดรุ่นสูงมาพร้อม NVLink / NVSwitch ที่ให้ Bandwidth ระหว่างการ์ดสูงถึง 900-1,800 GB/s ทำให้การทำ Tensor Parallelism (TP=2, TP=4, TP=8) ข้ามการ์ดไหลลื่นโดยไม่ติดคอขวด PCIe
AMD: คุ้ม memory แต่ต้องตรวจ support matrix
ฮาร์ดแวร์สาย AMD ROCm / HIP มักจะมอบความคุ้มค่าด้านอัตราส่วน VRAM per Dollar (แรมต่อราคาเงินที่จ่าย) ที่น่าดึงดูดใจมาก เช่น การ์ดฝั่ง Datacenter ตระกูล Instinct MI300X (192 GB HBM3) หรือฝั่ง Consumer/Workstation ตระกูล Radeon RDNA
อย่างไรก็ตาม สิ่งที่นักพัฒนาสาย AMD ต้องใส่ใจเป็นพิเศษคือ:
- Software & Kernel Support Matrix: แม้ว่า vLLM-ROCm, SGLang และ llama.cpp จะสามารถรันบน AMD ได้ดีขึ้นเรื่อยๆ แต่ความพร้อมของ Kernel อัลกอริทึม (เช่น FlashAttention, AWQ loader, FP8 KV, Speculative Decoding) จะขึ้นอยู่กับรุ่น GPU Architecture, ไดรเวอร์ ROCm, และเวอร์ชันของ Runtime Release อย่างใกล้ชิด
- Instinct vs Radeon: ฝั่ง Instinct MI300X / MI350 มีการปรับแต่งซอฟต์แวร์เกรดองค์กรมาอย่างแน่นหนา รองรับ FP8, FP8 KV, AWQ, และ AMD Quark (รวมถึง MXFP4) แต่การ์ดฝั่ง Radeon RDNA อาจจะมีข้อจำกัดเรื่อง Kernel Optimization บางตัวที่ไม่เท่า CUDA
คำแนะนำคือ: อย่าเพิ่งรีบเหมารวมว่า AMD รันไม่ได้ และอย่าเพิ่งเหมารวมว่า Quantization ชื่อเดียวกันจะรันได้สปีดเท่ากันบน AMD ทุกรุ่น ให้เปิดเช็กตัวเลือกที่ Calculator รองรับเฉพาะรุ่นการ์ดนั้นๆ ก่อนเสมอ
Consumer, workstation, datacenter
การแบ่งระดับฮาร์ดแวร์ออกเป็น 3 Tier ตามงบประมาณและภาระงาน:
- Consumer GPUs (RTX 5090 / 4090 / 3090): เหมาะสำหรับ Local Development, Personal Workstation และการรัน Single GPU Inference ในงบประมาณประหยัด การ์ดกลุ่มนี้ให้ Memory Bandwidth สูง (1,000+ GB/s) ในราคาเอากลับบ้านได้ แต่น่าเสียดายตรงที่มีข้อจำกัดเรื่อง VRAM Cap (สูงสุด 24-32 GB) และไม่มีสาย NVLink ในรุ่นใหม่ๆ
- Workstation GPUs (RTX 6000 Ada, Radeon PRO): เพิ่มความจุ VRAM ขึ้นมาเป็น 48 GB+, รองรับ ECC Memory ป้องกันข้อมูลผิดพลาด, มี Form Factor และอัตราการใช้พลังงานที่เหมาะสำหรับใส่เคสประกอบเซิร์ฟเวอร์สำนักงาน
- Datacenter GPUs (H100, H200, B200, DGX Station GB300, MI300X): ออกแบบมาเพื่อ High Concurrency Enterprise Fleet ที่ต้องเปิดบริการ 24/7 ใช้ความเร็วแรมระดับ HBM3/HBM3e (3,000+ GB/s) มีระบบระบายความร้อน Liquid Cooling และสถาปัตยกรรม NVSwitch เพื่อเชื่อมต่อ Tensor Parallelism ข้ามการ์ดหลายใบได้อย่างไร้รอยต่อ
(ตารางด้านล่างแสดง ฮาร์ดแวร์และราคาใน calculator ซึ่งเป็นราคาประมาณการวางแผนในประเทศไทย ไม่ใช่ใบเสนอราคาซื้อขายจริง)
คำถามก่อนซื้อ
รายการเช็กเคลิสต์ 5 ข้อที่ต้องตอบตัวเองให้ได้ก่อนลงเงินซื้อหรือเช่าฮาร์ดแวร์:
- โมเดลขนาดกี่ B และใช้ Quantization Format อะไร?
- ต้องรองรับ Working Context ความยาวเท่าไหร่ (เช่น 4K, 32K, หรือ 128K)?
- ต้องการรับ Concurrent Users พร้อมกันกี่คน (Batch Size)?
- เป้าหมายระบบเน้นความเร็วตอบสนองส่วนบุคคล (Low Latency / TTFT) หรือเน้นปริมาณงานรวม (High Throughput)?
- ทีมงานมีความเชี่ยวชาญในการบริหารจัดการระบบปฏิบัติการใด (macOS, Linux CUDA, หรือ ROCm)?
นำคำตอบทั้งหมดไปใส่ลงใน LLM VRAM Calculator เพื่อตรวจเช็ก VRAM Peak และสปีดก่อนสั่งซื้อจริง!
CATALOG PRICE LIST
ฮาร์ดแวร์และราคาใน calculator
รายการนี้อ่านจาก catalog เดียวกับ dropdown และ result card ราคา discrete GPU เป็นราคาการ์ดโดยประมาณ ส่วน Apple, DGX และ Strix Halo เป็นราคาทั้งเครื่องตามสเปกที่มีหลักฐาน ตรวจ stock, warranty และใบเสนอราคาจริงก่อนซื้อ
Consumer และเครื่องใช้งานทั่วไป
| กลุ่ม | ฮาร์ดแวร์ | Memory และราคา |
|---|---|---|
| NVIDIA RTX 30 Desktop | RTX 3060 | 12 GB: ฿12,900 |
| NVIDIA RTX 30 Desktop | RTX 3060 Ti | 8 GB: ฿13,900 |
| NVIDIA RTX 30 Desktop | RTX 3070 | 8 GB: ฿16,900 |
| NVIDIA RTX 30 Desktop | RTX 3070 Ti | 8 GB: ฿18,900 |
| NVIDIA RTX 30 Desktop | RTX 3080 | 10 GB: ฿24,900 |
| NVIDIA RTX 30 Desktop | RTX 3080 | 12 GB: ฿26,900 |
| NVIDIA RTX 30 Desktop | RTX 3080 Ti | 12 GB: ฿29,900 |
| NVIDIA RTX 30 Desktop | RTX 3090 | 24 GB: ฿46,900 |
| NVIDIA RTX 30 Desktop | RTX 3090 Ti | 24 GB: ฿52,900 |
| NVIDIA RTX 40 Desktop | RTX 4060 | 8 GB: ฿11,900 |
| NVIDIA RTX 40 Desktop | RTX 4060 Ti | 8 GB: ไม่มีราคาตรงสเปก 16 GB: ไม่มีราคาตรงสเปก |
| NVIDIA RTX 40 Desktop | RTX 4070 | 12 GB: ฿22,900 |
| NVIDIA RTX 40 Desktop | RTX 4070 Super | 12 GB: ฿24,900 |
| NVIDIA RTX 40 Desktop | RTX 4070 Ti | 12 GB: ฿29,900 |
| NVIDIA RTX 40 Desktop | RTX 4070 Ti Super | 16 GB: ฿34,900 |
| NVIDIA RTX 40 Desktop | RTX 4080 | 16 GB: ฿49,900 |
| NVIDIA RTX 40 Desktop | RTX 4080 Super | 16 GB: ฿44,900 |
| NVIDIA RTX 40 Desktop | RTX 4090 | 24 GB: ฿79,900 |
| NVIDIA RTX 50 Desktop | RTX 5060 | 8 GB: ฿14,900 |
| NVIDIA RTX 50 Desktop | RTX 5060 Ti | 8 GB: ไม่มีราคาตรงสเปก 16 GB: ฿25,500 |
| NVIDIA RTX 50 Desktop | RTX 5070 | 12 GB: ฿27,900 |
| NVIDIA RTX 50 Desktop | RTX 5070 Ti | 16 GB: ฿42,400 |
| NVIDIA RTX 50 Desktop | RTX 5080 | 16 GB: ฿47,900 |
| NVIDIA RTX 50 Desktop | RTX 5090 | 32 GB: ฿179,900 |
| NVIDIA RTX 40 Laptop | RTX 4060 Laptop | 8 GB: ฿39,900 |
| NVIDIA RTX 40 Laptop | RTX 4070 Laptop | 8 GB: ฿49,900 |
| NVIDIA RTX 40 Laptop | RTX 4080 Laptop | 12 GB: ฿69,900 |
| NVIDIA RTX 40 Laptop | RTX 4090 Laptop | 16 GB: ฿99,900 |
| Apple Silicon | M1 | 8 GB: ไม่มีราคาตรงสเปก 16 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M1 Pro | 16 GB: ไม่มีราคาตรงสเปก 32 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M1 Max | 32 GB: ไม่มีราคาตรงสเปก 64 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M1 Ultra | 64 GB: ไม่มีราคาตรงสเปก 128 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M2 | 8 GB: ไม่มีราคาตรงสเปก 16 GB: ไม่มีราคาตรงสเปก 24 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M2 Pro | 16 GB: ไม่มีราคาตรงสเปก 32 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M2 Max | 32 GB: ไม่มีราคาตรงสเปก 64 GB: ไม่มีราคาตรงสเปก 96 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M2 Ultra | 64 GB: ไม่มีราคาตรงสเปก 128 GB: ไม่มีราคาตรงสเปก 192 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M3 | 8 GB: ไม่มีราคาตรงสเปก 16 GB: ไม่มีราคาตรงสเปก 24 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M3 Pro | 18 GB: ไม่มีราคาตรงสเปก 36 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M3 Max (30-core GPU) | 36 GB: ไม่มีราคาตรงสเปก 96 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M3 Max (40-core GPU) | 48 GB: ไม่มีราคาตรงสเปก 64 GB: ไม่มีราคาตรงสเปก 128 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M3 Ultra | 96 GB: ฿242,400 256 GB: ไม่มีราคาตรงสเปก 512 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M4 | 16 GB: ฿59,900 24 GB: ฿66,900 32 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M4 Pro | 24 GB: ฿64,900 48 GB: ฿85,900 |
| Apple Silicon | M4 Max (32-core GPU) | 36 GB: ฿89,900 |
| Apple Silicon | M4 Max (40-core GPU) | 48 GB: ไม่มีราคาตรงสเปก 64 GB: ฿124,900 128 GB: ไม่มีราคาตรงสเปก |
| Apple Silicon | M5 | 16 GB: ฿48,400 24 GB: ฿51,900 32 GB: ฿58,900 |
| Apple Silicon | M5 Pro (15-core CPU / 16-core GPU) | 24 GB: ฿61,900 48 GB: ฿82,900 64 GB: ฿96,900 |
| Apple Silicon | M5 Pro (18-core CPU / 20-core GPU) | 24 GB: ฿68,900 48 GB: ฿89,900 64 GB: ฿103,900 |
| Apple Silicon | M5 Max (18-core CPU / 32-core GPU) | 36 GB: ฿89,900 |
| Apple Silicon | M5 Max (18-core CPU / 40-core GPU) | 48 GB: ฿110,900 64 GB: ฿124,900 128 GB: ฿180,900 |
| Apple Silicon | M5 Ultra (30-core CPU / 64-core GPU) | 96 GB: ฿199,900 256 GB: ฿339,900 |
| Apple Silicon | M5 Ultra (36-core CPU / 80-core GPU) | 96 GB: ฿245,400 256 GB: ฿385,400 |
| Apple Silicon | M6 | 16 GB: ฿32,900 24 GB: ฿39,900 32 GB: ฿46,900 |
| AMD Radeon RDNA3 Desktop | RX 7900 XTX | 24 GB: ฿39,900 |
| AMD Radeon RDNA3 Desktop | RX 7900 XT | 20 GB: ฿36,900 |
| AMD Radeon RDNA3 Desktop | RX 7900 GRE | 16 GB: ฿21,900 |
| AMD Radeon RDNA3 Desktop | RX 7800 XT | 16 GB: ฿17,900 |
| AMD Radeon RDNA3 Desktop | RX 7700 XT | 12 GB: ฿15,900 |
| AMD Radeon RDNA3 Desktop | RX 7600 XT | 16 GB: ฿12,900 |
| AMD Radeon RDNA4 Desktop | RX 9060 XT | 16 GB: ฿15,900 |
| AMD Radeon RDNA4 Desktop | RX 9070 XT | 16 GB: ฿25,900 |
| AMD Radeon RDNA4 Desktop | RX 9070 | 16 GB: ไม่มีราคาตรงสเปก |
| AMD Strix Halo | Strix Halo | 128 GB: ฿99,990 |
| Intel Arc Desktop | Arc A770 | 16 GB: ฿12,900 |
| Intel Arc Desktop | Arc B570 | 10 GB: ฿7,990 |
| Intel Arc Desktop | Arc B580 | 12 GB: ฿9,900 |
Workstation
| กลุ่ม | ฮาร์ดแวร์ | Memory และราคา |
|---|---|---|
| NVIDIA RTX A Workstation | RTX A2000 | 12 GB: ฿11,500 |
| NVIDIA RTX A Workstation | RTX A4000 | 16 GB: ฿37,900 |
| NVIDIA RTX A Workstation | RTX A4500 | 20 GB: ฿37,400 |
| NVIDIA RTX A Workstation | RTX A5000 | 24 GB: ฿50,000 |
| NVIDIA RTX A Workstation | RTX A6000 | 48 GB: ฿119,000 |
| NVIDIA RTX Ada Workstation | RTX 2000 Ada | 16 GB: ฿29,900 |
| NVIDIA RTX Ada Workstation | RTX 4000 SFF Ada | 20 GB: ฿53,500 |
| NVIDIA RTX Ada Workstation | RTX 4000 Ada | 20 GB: ฿55,900 |
| NVIDIA RTX Ada Workstation | RTX 4500 Ada | 24 GB: ฿115,500 |
| NVIDIA RTX Ada Workstation | RTX 5000 Ada | 32 GB: ฿195,000 |
| NVIDIA RTX Ada Workstation | RTX 6000 Ada | 48 GB: ฿339,000 |
| NVIDIA RTX PRO Workstation | RTX PRO 2000 Blackwell | 16 GB: ฿62,900 |
| NVIDIA RTX PRO Workstation | RTX PRO 4000 Blackwell SFF | 24 GB: ฿72,900 |
| NVIDIA RTX PRO Workstation | RTX PRO 4000 Blackwell | 24 GB: ฿108,000 |
| NVIDIA RTX PRO Workstation | RTX PRO 4500 Blackwell | 32 GB: ฿149,000 |
| NVIDIA RTX PRO Workstation | RTX PRO 5000 Blackwell | 48 GB: ฿299,000 72 GB: ฿315,900 |
| NVIDIA RTX PRO Workstation | RTX PRO 6000 Blackwell | 96 GB: ฿599,000 |
| NVIDIA RTX PRO Workstation | RTX PRO 6000 Blackwell Max-Q | 96 GB: ฿589,000 |
| AMD Radeon PRO Workstation | Radeon PRO W6800 | 32 GB: ฿32,900 |
| AMD Radeon PRO Workstation | Radeon PRO W7800 | 32 GB: ฿95,000 |
| AMD Radeon PRO Workstation | Radeon PRO W7900 | 48 GB: ฿119,000 |
| AMD Radeon PRO Workstation | Radeon AI PRO R9700 | 32 GB: ฿60,900 |
| Intel Arc Pro Workstation | Arc Pro B50 | 16 GB: ฿14,900 |
| Intel Arc Pro Workstation | Arc Pro B60 | 24 GB: ฿27,900 |
| Intel Arc Pro Workstation | Arc Pro B70 | 32 GB: ฿63,900 |
Datacenter และ appliance สำหรับ AI
| กลุ่ม | ฮาร์ดแวร์ | Memory และราคา |
|---|---|---|
| NVIDIA GB10 Blackwell | DGX Spark | 128 GB: ฿182,900 |
| NVIDIA GB300 Grace Blackwell Ultra | DGX Station GB300 | 748 GB: ฿4,166,580 |
| Huawei Ascend 310P | Atlas 300I Duo 48GB | 48 GB: ฿42,000 |
| Huawei Ascend 310P | Atlas 300I Duo | 96 GB: ฿62,000 |
| Huawei Ascend 910B | Ascend 910B | 64 GB: ฿520,000 |
| Huawei Ascend 910C | Ascend 910C | 128 GB: ไม่มีราคาตรงสเปก |
| Huawei Ascend 950 | Atlas 350 | 112 GB: ไม่มีราคาตรงสเปก |
| AMD Instinct Datacenter | Instinct MI50 | 32 GB: ฿14,900 |
| AMD Instinct Datacenter | Instinct MI300X | 192 GB: ฿610,000 |
| AMD Instinct Datacenter | Instinct MI325X | 256 GB: ฿650,000 |
| AMD Instinct Datacenter | Instinct MI355X | 288 GB: ฿780,000 |
| NVIDIA Datacenter Volta | Tesla V100 | 16 GB: ไม่มีราคาตรงสเปก |
| NVIDIA Datacenter Volta | Tesla V100 | 32 GB: ไม่มีราคาตรงสเปก |
| NVIDIA Datacenter Volta | Tesla V100S | 32 GB: ไม่มีราคาตรงสเปก |
| NVIDIA Datacenter Turing | Tesla T4 | 16 GB: ไม่มีราคาตรงสเปก |
| NVIDIA Datacenter Ampere | A100 PCIe | 40 GB: ฿340,000 |
| NVIDIA Datacenter Ampere | A100 PCIe | 80 GB: ฿510,000 |
| NVIDIA Datacenter Ampere | A100 SXM | 80 GB: ฿510,000 |
| NVIDIA Datacenter Ada | L4 | 24 GB: ฿92,000 |
| NVIDIA Datacenter Ada | L40 | 48 GB: ฿220,000 |
| NVIDIA Datacenter Ada | L40S | 48 GB: ฿258,000 |
| NVIDIA Datacenter Hopper | H100 PCIe | 80 GB: ฿850,000 |
| NVIDIA Datacenter Hopper | H100 SXM | 80 GB: ฿920,000 |
| NVIDIA Datacenter Hopper | H200 NVL | 141 GB: ฿1,090,000 |
| NVIDIA Datacenter Hopper | H200 SXM | 141 GB: ฿1,290,000 |
| NVIDIA Datacenter Blackwell | B100 | 192 GB: ฿1,050,000 |
| NVIDIA Datacenter Blackwell | B200 | 180 GB: ฿1,350,000 |
| NVIDIA Datacenter Blackwell | GB200 Superchip (2×Blackwell) | 372 GB: ฿2,600,000 |
| NVIDIA Datacenter Blackwell | GB200 NVL72 (72-GPU rack) | 13392 GB: ฿102,000,000 |
| NVIDIA Datacenter Blackwell | B300 | 288 GB: ฿1,800,000 |
| NVIDIA Datacenter Blackwell | GB300 Superchip (2×Blackwell Ultra) | 576 GB: ฿3,600,000 |
| NVIDIA Datacenter Blackwell | GB300 NVL72 (72-GPU rack) | 20736 GB: ฿140,100,000 |
| NVIDIA Datacenter Rubin | Rubin | 288 GB: ไม่มีราคาตรงสเปก |
| NVIDIA Datacenter Rubin | Vera Rubin Superchip (2×Rubin) | 576 GB: ไม่มีราคาตรงสเปก |
| NVIDIA Datacenter Rubin | Vera Rubin NVL72 (72-GPU rack) | 20736 GB: ฿265,200,000 |
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ