LOCAL LLM FIELD GUIDE
เลือก Local LLM ตามงาน: ภาษาไทย, chatbot, agent, coding และ workflow
อย่าเริ่มจากการมองหา โมเดลที่ดีที่สุดในโลก แต่ให้คิดเหมือนการ เลือกคนเข้าทำงาน ให้ตรงกับตำแหน่ง: ประเมินความเข้ากันได้ของภาษาไทย, ความแม่นยำในการเรียกใช้เครื่องมือ (Tool Calling), ทักษะการเขียนโค้ด (Coding), การส่งออกข้อมูลโครงสร้าง (Structured JSON), ความยาวบริบท (Context), และเพดานแรม (Memory Floor) ที่การ์ดจอของคุณรับไหว จากนั้นทดสอบด้วยชุดข้อสอบจริงขององค์กรคุณเอง
WORKLOAD PROFILE
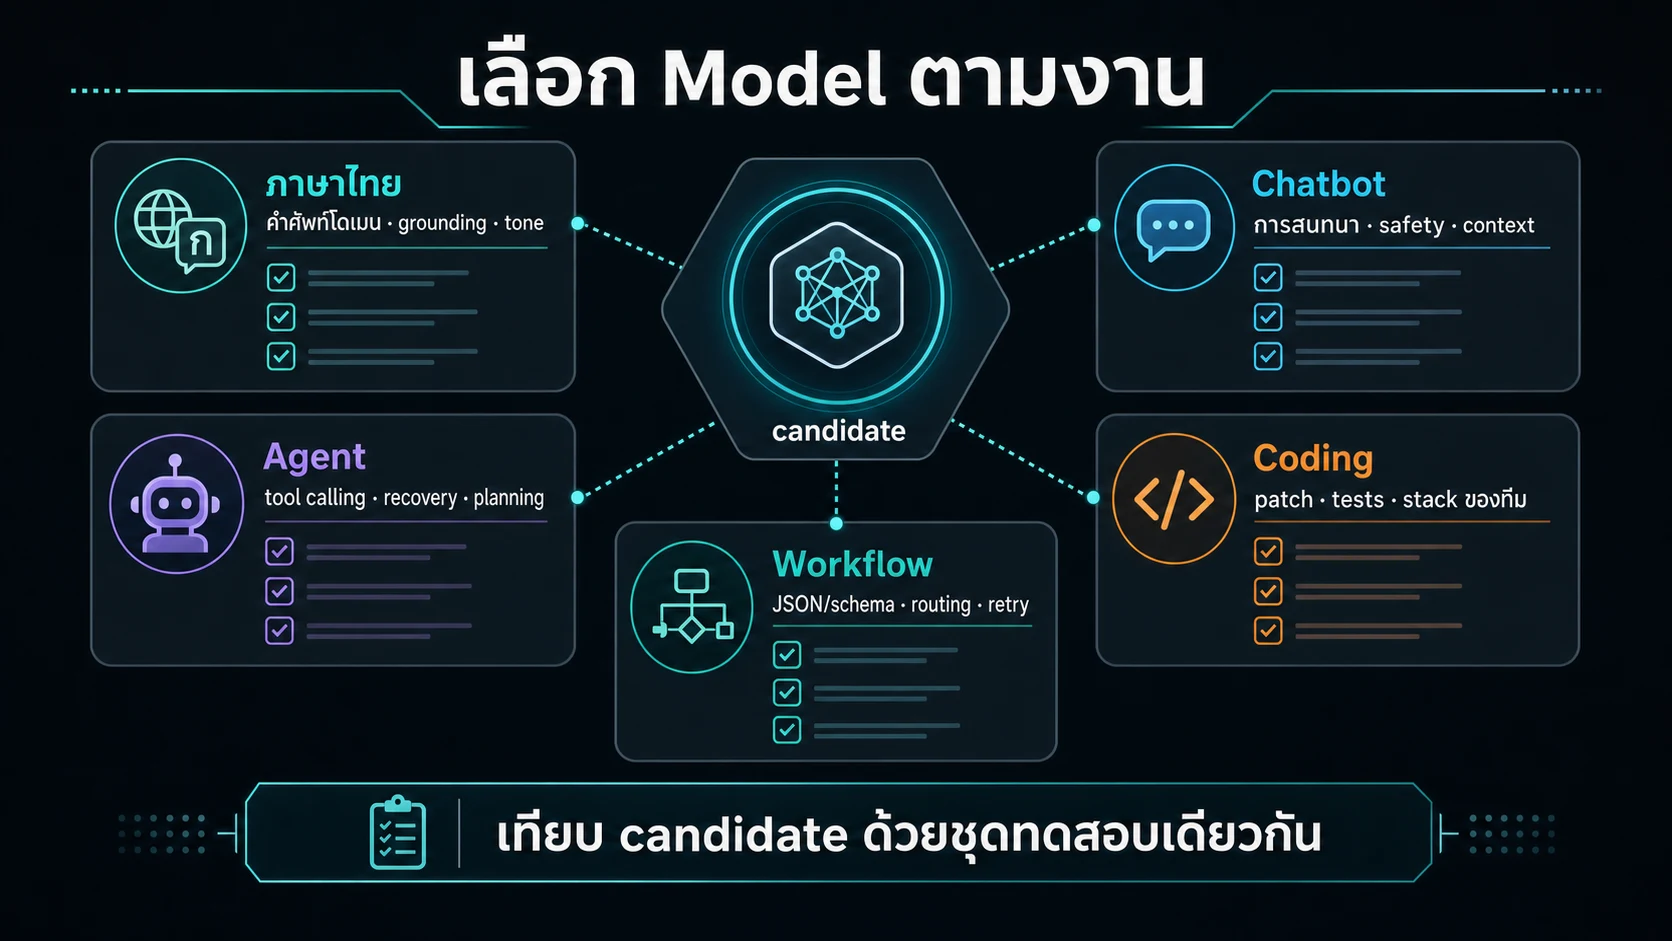
เปรียบเทียบ candidate ด้วย scorecard เดียวกัน
- ภาษาไทย
- domain, grounding, tone
- Agent
- tool schema, recovery, planning
- Coding
- patch, tests, stack
- Workflow
- JSON schema, retry
ใช้กับงานจริง
ใช้ scorecard เดียวกับทุก candidate
ชื่อ model ไม่ตอบว่าเหมาะกับงานของคุณหรือไม่ สร้างชุดทดสอบเล็กที่สะท้อน prompt, tool, เอกสาร และข้อผิดพลาดที่ผู้ใช้พบจริง
ให้ candidate ผ่านเกณฑ์คุณภาพก่อน แล้วจึงเทียบ memory และ tok/s ใน runtime เดียวกัน วิธีนี้ทำให้การเลือก model อธิบายย้อนหลังได้
| งาน | เกณฑ์ผ่าน | failure case ที่ต้องมี |
|---|---|---|
| ภาษาไทย | คำสั่ง, tone และศัพท์โดเมนถูกต้อง | ตอบนอกเอกสารหรือแปลคำเฉพาะผิด |
| chatbot | ตอบต่อเนื่องและอ้างอิง context | หลุด topic ในหลาย turn |
| agent | tool call ตรง schema | tool error แล้วไปต่อไม่ได้ |
| coding | patch ผ่าน test ที่เกี่ยวข้อง | แก้ส่วนอื่นจน regression |
| workflow | JSON ตรง schema และ retry ได้ | field หายหรือ type ไม่ตรง |
ชุด eval ขั้นต่ำที่เริ่มได้
- 10 prompt ภาษาไทยจากงานจริง
- conversation หลาย turn ที่มีเอกสารอ้างอิง
- tool result ที่ผิดรูปแบบหนึ่งชุด
- งานแก้ code พร้อม test feedback
- structured output ที่มี invalid JSON และ retry
{
  "ticket_id": "string",
  "category": "billing | support | security",
  "needs_human": true
}
ภาษาไทย
การเลือกโมเดลสำหรับงานภาษาไทย ต้องเริ่มจากการทดสอบกับโจทย์งานจริงของคุณเอง ไม่ใช่แค่ดูว่าโมเดลพิมพ์ภาษาไทยออกเป็นประโยคได้หรือไม่:
- Instruction Following ภาษาไทย: ตรวจสอบว่าโมเดลเข้าใจคำสั่งที่มีเงื่อนไขซับซ้อนในภาษาไทยได้ถูกต้อง ไม่หลุดกรอบ หรือแปลคำสั่งกลับไปเป็นภาษาอังกฤษ
- Retrieval Grounding (RAG): ทดสอบว่าเมื่อป้อนเอกสารอ้างอิงภาษาไทยเข้าไป โมเดลสามารถตอบคำถามโดยยึดตามข้อเท็จจริงในเอกสารได้แม่นยำ ไม่แต่งเรื่องขึ้นมาเอง (Hallucination)
- นโยบายความสุภาพและศัพท์เฉพาะทาง (Policy Tone & Domain Terms): ตรวจสอบระดับภาษา (เป็นทางการ, กึ่งทางการ) และความถูกต้องของศัพท์เฉพาะทางกฎหมาย การแพทย์ หรือการเงิน
- แหล่งข้อมูลและ Benchmark: Model Card เช่น ThaiLLM-8B เป็นจุดเริ่มต้นที่ดีในการดูสเปกและสถาปัตยกรรม แต่ไม่สามารถใช้แทนการทดสอบกับ Workload ประจำวันของทีมคุณได้
Chatbot และ agent
การแยกระหว่างงาน Chatbot ทั่วไป กับงาน AI Agent ช่วยให้เลือกขนาดและความสามารถของโมเดลได้ตรงจุด:
- Chatbot (ระบบสนทนา): สิ่งสำคัญคือความเป็นธรรมชาติของบทสนทนา, ความสุภาพ, การรักษาความปลอดภัย (Safety & Guardrails) และความสามารถในการจดจำบริบทของการคุยย้อนหลังหลายรอบ (Multi-turn Context Retention) โดยไม่ลืมสิ่งที่เคยคุยไว้
- AI Agent (ระบบสั่งการอัตโนมัติ): สิ่งสำคัญสูงสุดคือ **Tool Calling / Function Calling** โมเดลต้องสามารถแกะคำสั่งของผู้ใช้แล้วสร้างเป็น Argument ในฟอร์แมต JSON Schema เพื่อเรียกใช้ API หรือฐานข้อมูลได้อย่างถูกต้อง 100%
- การกู้คืนข้อผิดพลาด (Error Recovery): เมื่อเครื่องมือภายนอกส่ง Error กลับมา ตัว Agent ต้องเข้าใจข้อความ Error แล้วคิดวิธีลองใหม่ได้โดยไม่ติดลูปหรือหยุดทำงานไปดื้อๆ
การทดสอบโมเดล Agent ต้องเน้นทดสอบเคสที่ยากและเคสที่เครื่องมือพัง (Failure Cases) ไม่ใช่ทดสอบเพียงแค่การตอบคำถามสั้นๆ ประโยคเดียว
Coding และ structured workflow
งานสายเทคนิคต้องการความแม่นยำของโครงสร้างและตรรกะระดับสูง:
- งานเขียนโค้ด (Coding): โมเดลต้องเข้าใจภาษาและเทคโนโลยีที่ทีมของคุณใช้งานจริง (เช่น Python, TypeScript, Go, SQL), สามารถสร้าง Patch หรือฟังก์ชันที่นำไปรันผ่าน Unit Tests ได้จริง และสามารถนำ Error จาก Compiler/Test มาแก้ไขโค้ดตัวเองได้อย่างถูกต้อง
- งานข้อมูลโครงสร้าง (Structured Workflows): ระบบอัตโนมัติส่วนใหญ่อยู่บนพื้นฐานของ JSON Schema, XML หรือการสกัดข้อมูล (Data Extraction) ลงฐานข้อมูล
- ความถูกต้องของฟอร์แมต (Schema Validity): โมเดลที่ดีสำหรับงาน Workflow ต้องปิดปีกกา
{}ครบถ้วน, กำหนด Data Type ของแต่ละ Field ได้ถูกต้อง และรองรับระบบ Retry แบบ Deterministic
โปรดจำไว้ว่า: โมเดลที่คุยเก่งหรือเขียนบทความสละสลวย อาจไม่ใช่โมเดลที่ส่งออกข้อมูล JSON ได้เสถียรที่สุด!
Memory floor และ deployability
โมเดลที่ฉลาดที่สุดในโลกจะไม่มีประโยชน์เลยถ้ามันไม่สามารถเปิดใช้งานจริงบนฮาร์ดแวร์ของคุณได้ (Not Deployable):
- คำนวณ Memory Floor: ตรวจสอบขนาด VRAM ขั้นต่ำที่ต้องใช้ โดยนำขนาด Weights (ตามระดับ Quantization) มารวมกับ KV Cache สำหรับความยาว Context และจำนวนผู้ใช้ที่คุณต้องการรองรับจริง
- คัดเลือกตัวเก็ง (Shortlist Candidates): เลือกโมเดลตัวเก็ง 2-4 ตัวที่ขนาดพอดีกับการ์ดจอของคุณ เช่น หากใช้การ์ด 24 GB อาจเลือกระหว่าง โมเดล 14B-32B แบบ 8-bit/4-bit หรือโมเดลขนาดเล็กที่มีคะแนนด้าน Coding สูงเป็นพิเศษ
- เปรียบเทียบด้วยเครื่องมือ: ใช้ LLM VRAM Calculator และชุดข้อสอบ (Eval Suite) เดียวกัน เพื่อเปรียบเทียบความคุ้มค่าระหว่างต้นทุนฮาร์ดแวร์, ความเร็ว (tok/s) และคุณภาพคำตอบก่อนตัดสินใจนำขึ้นระบบจริง
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ