LOCAL LLM FIELD GUIDE
การจัดการ VRAM สำหรับ MoE ขนาดใหญ่บน Multi-GPU Cluster
โมเดล Mixture-of-Experts (MoE) อย่าง DeepSeek-V3/R1 (671B Total / 37B Active) เปรียบเหมือน ห้องประชุมที่มีผู้เชี่ยวชาญ 256 คน และมีพนักงานต้อนรับคอยส่งงานให้ผู้เชี่ยวชาญ 8 คนที่ตรงกับคำถาม แม้คำนวณจริงใช้สมองเพียง 37B แต่ VRAM ทั้งหมดบน Cluster จำเป็นต้องมีเก้าอี้ให้ผู้เชี่ยวชาญทั้ง 671B นั่งค้างไว้เสมอ การใช้ Expert Parallelism (EP), Tensor Parallelism (TP) และ Multi-Head Latent Attention (MLA) จึงเป็นกุญแจสำคัญ
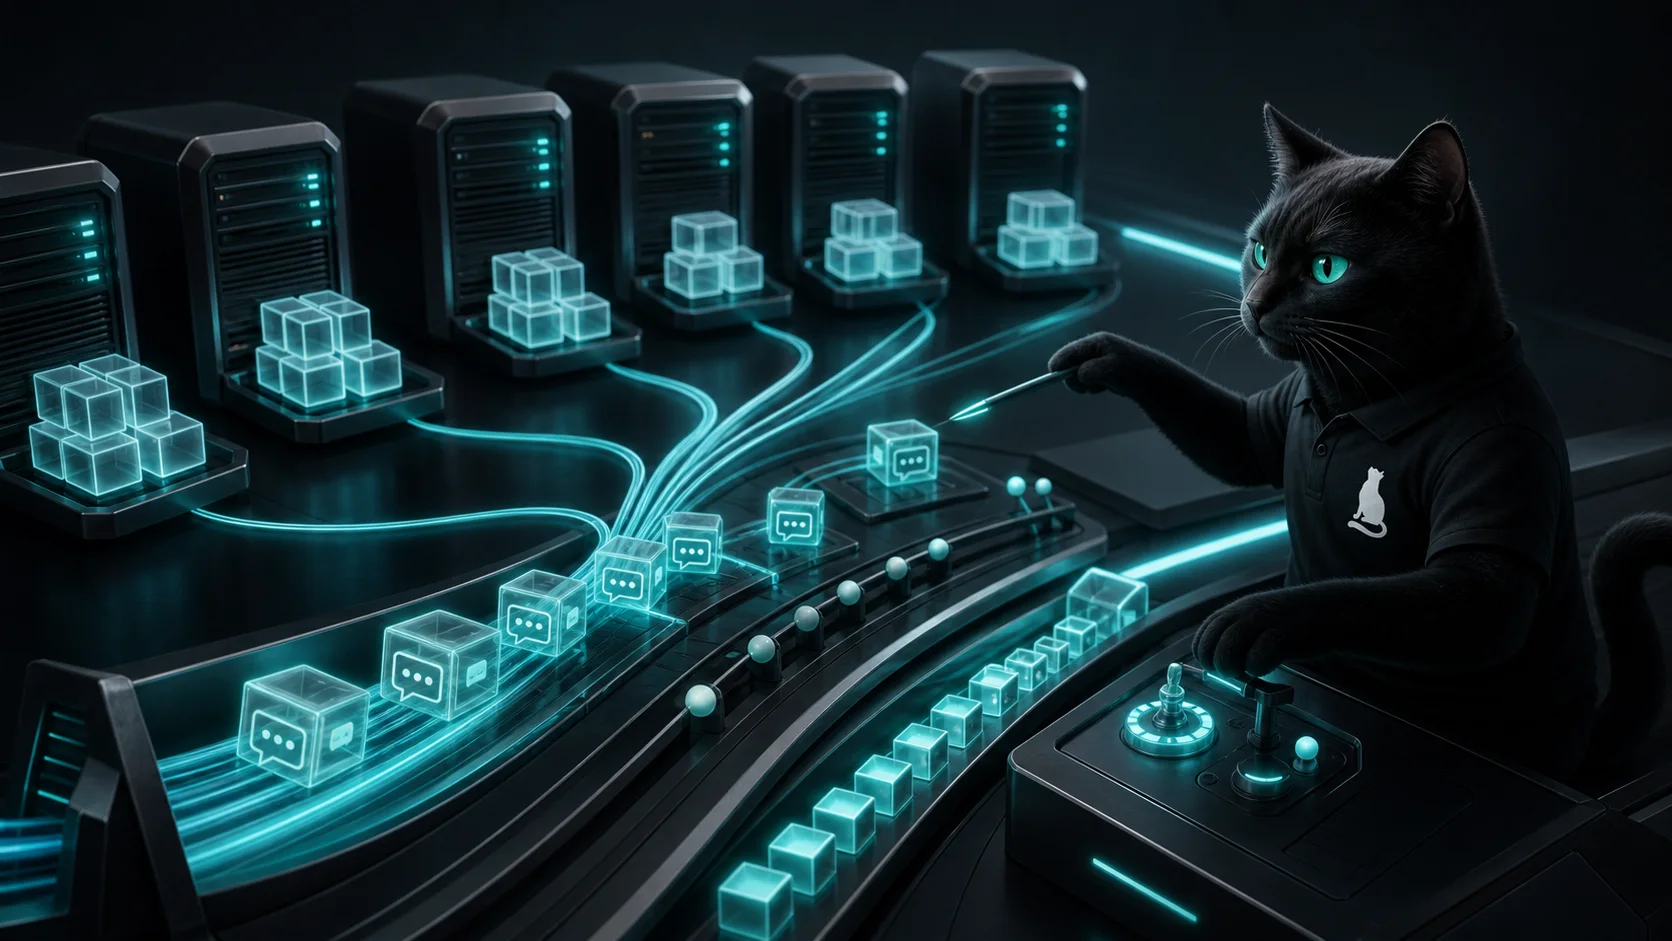
MIXTURE OF EXPERTS
671B Total Parameters ในแรม 37B Active คำนวณ
- VRAM Footprint
- ต้องจอง Total Weights 671B ทั้งหมดบน Cluster
- Compute Speed
- วิ่งเร็วเท่ากับ 37B Active Parameters
ใช้กับงานจริง
วางแผน VRAM และ Multi-GPU สำหรับ MoE โมเดล
เริ่มจาก Total Parameters (671B) เพื่อจอง VRAM และใช้ Active Parameters (37B) เพื่อประมาณการความเร็ว
ใช้ Expert Parallelism (EP) กระจาย Expert ข้ามการ์ดบน NVLink และใช้ FP8 KV เพื่อลดขนาดแรม
| ปัจจัย | คำแนะนำ | สิ่งที่ต้องระวัง |
|---|---|---|
| Model Weights (671B) | คิดแรมจาก 671B ไม่ใช่ 37B (FP8 ใช้ ~670 GB) | VRAM ไม่พอโหลดโมเดลไม่ขึ้นตั้งแต่เริ่ม |
| Multi-GPU Interconnect | ใช้ NVLink สำหรับ Expert Parallelism (EP) | การ์ด PCIe แบบไม่มี NVLink จะติด All-to-All Bottleneck |
| KV Cache Architecture | DeepSeek MLA ช่วยลด KV Cache ลง >90% | ยังมีงบ KV รวมเมื่อรับ Concurrency สูง |
| Expert Offloading | Offload บาง Expert ไป CPU/NVMe แรม | ช่วยให้รันบนการ์ดจอเล็กได้ แต่ลด Decode Speed |
เช็กริสต์ก่อน Deploy MoE Cluster
- รวม VRAM ของทุก GPU บน Cluster ให้เกินขนาด Total Weights + KV Overhead
- ตรวจไดรเวอร์ NVLink / NVSwitch หรือ InfiniBand ระหว่างการ์ด
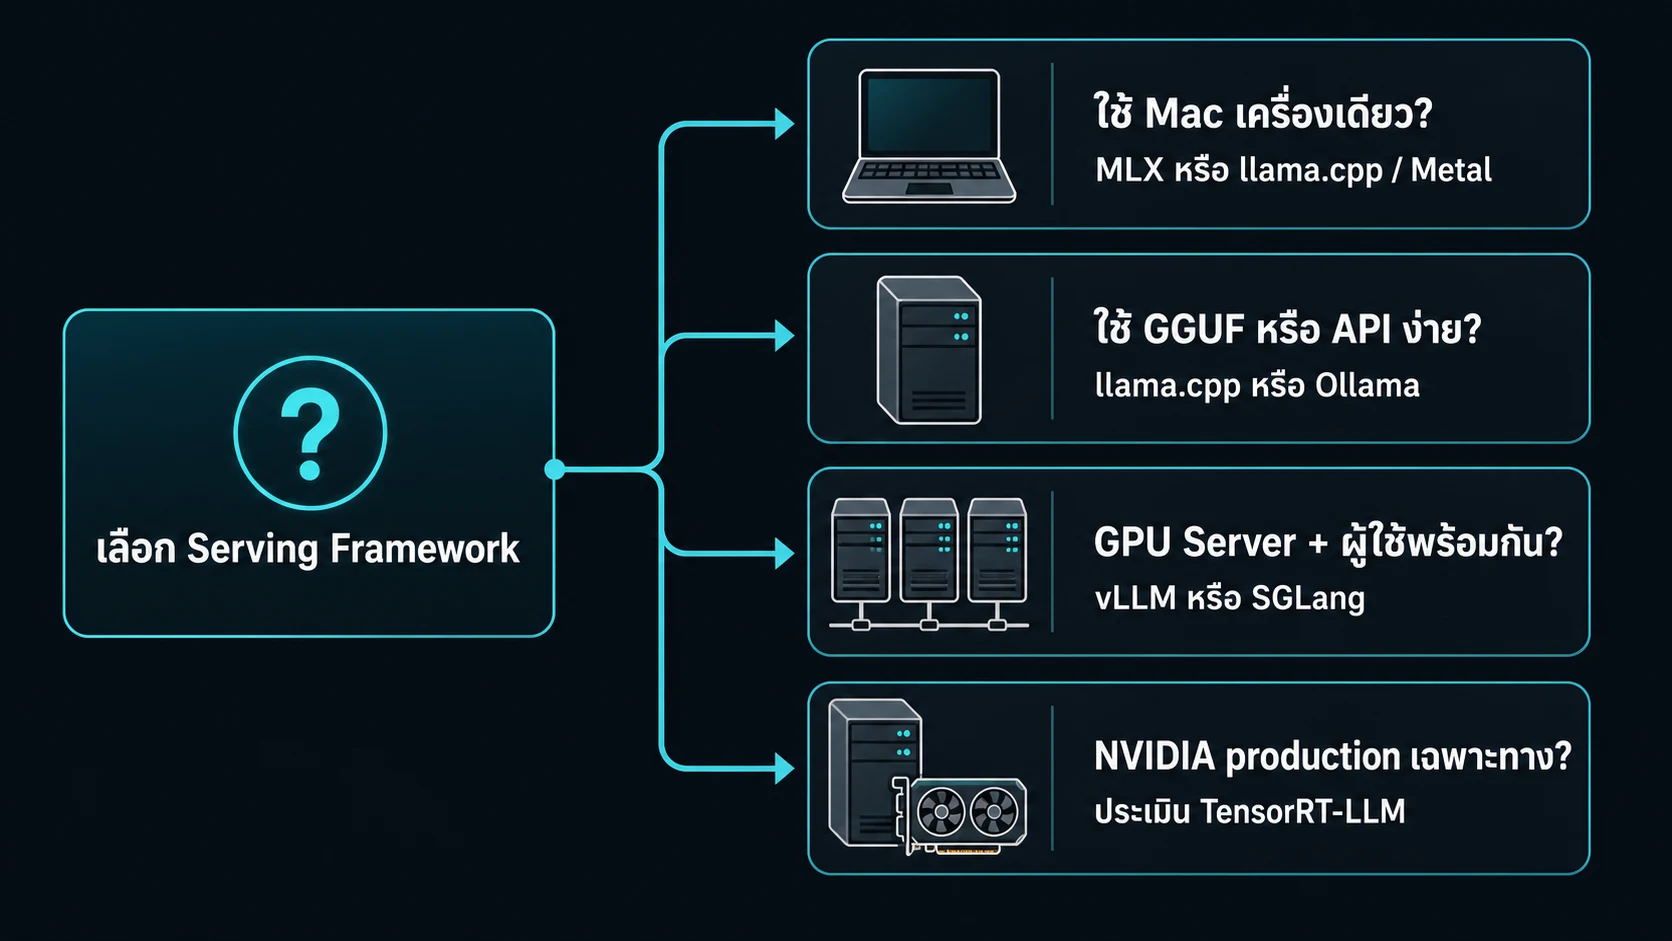
- เลือก runtime ที่มี EP และ MLA support เช่น vLLM หรือ SGLang
- ทดสอบ FP8 E4M3 Weights กับ FP8 KV Cache ก่อนปรับเป็น 4-bit
vllm serve deepseek-ai/DeepSeek-V3 \
  --tensor-parallel-size 1 \
  --pipeline-parallel-size 1 \
  --expert-parallel-size 8 \
  --kv-cache-dtype fp8 \
  --max-model-len 32768
Active vs Total Parameters ในงบ VRAM
โมเดล MoE อย่าง DeepSeek-V3 มีพารามิเตอร์รวมสูงถึง 671B (Total Parameters) แต่ในแต่ละ Step คำนวณจะเลือกใช้ Expert เพียง 8 ตัวบวก 1 Shared Expert ทำให้มี Active Parameters เพียง 37B
สิ่งที่ต้องระวังคือ: คำว่า 37B Active Parameters ไม่ได้แปลว่าคุณจะใช้การ์ดจอที่ VRAM พอเก็บแค่ 37B แล้วรันได้! เพราะตัวเซิร์ฟเวอร์ต้องโหลดโครงสร้างสมองและ Expert ทั้งหมด 256 ตัว (671B) ค้างไว้บนแรมตลอดเวลา ดังนั้นงบ VRAM สำหรับ Model Weights ยังคงยึดตามขนาด 671B เต็มๆ (ที่ FP8 ใช้แรม ~670 GB) ส่วนความเร็ว Compute Speed (TFLOPS) จะวิ่งเร็วเหมือนโมเดลขนาด 37B
Multi-GPU Parallelism: EP, TP และ PP
การรัน MoE ขนาดหลายร้อยพันล้านพารามิเตอร์ ต้องอาศัยการกระจายภาระข้าม GPUs หลายใบ (Multi-GPU Cluster) ผ่าน 3 เทคนิคหลัก:
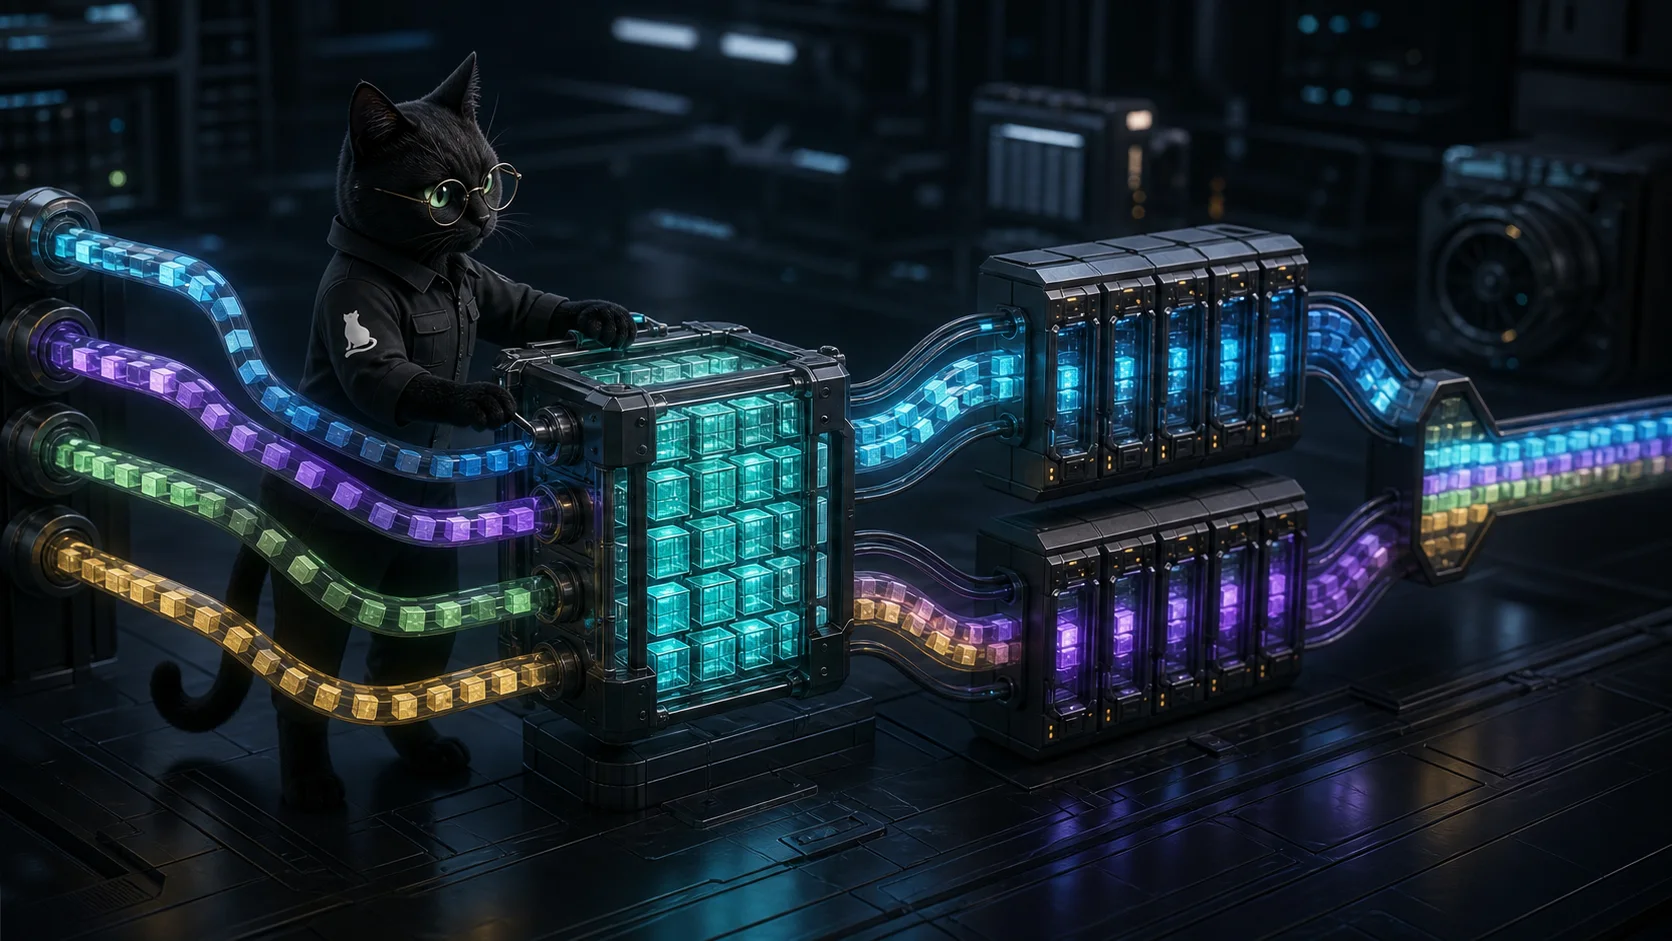
- Expert Parallelism (EP): กระจาย Expert ย่อยๆ ไปไว้คนละ GPU (เช่น GPU#1 เก็บ Expert 1-32, GPU#2 เก็บ Expert 33-64) วิธีนี้ช่วยประหยัด VRAM ต่อการ์ดได้มหาศาล แต่สร้างคอขวดที่การสื่อสารข้ามการ์ด All-to-All Communication (Token Routing) จึงต้องมีสาย NVLink ความเร็วสูง
- Tensor Parallelism (TP): หั่น Matrix เดียวกันไปคำนวณพร้อมกัน เหมาะสำหรับ Shared Experts และ Attention Layers เพื่อเพิ่มสปีด
- Pipeline Parallelism (PP): สับชั้นของโมเดลตามความลึก (Layer Stack) เหมาะสำหรับการข้ามโหนด (Multi-Node Cluster) ที่เชื่อมผ่าน InfiniBand หรือ RoCE
MLA (Multi-Head Latent Attention) ช่วยชีวิต KV Cache
ข้อได้เปรียบอันโดดเด่นของ DeepSeek-V3 / R1 คือการนำสถาปัตยกรรม MLA มาใช้ แทนที่จะเก็บ Key-Value states ของทุก Head แยกกันเต็มๆ (MHA) MLA จะบีบอัด (Compress) Key และ Value ให้อยู่ในรูปแบบ Latent Vector ความยาวเพียง 576-dim
ผลลัพธ์คือ VRAM ฝั่ง KV Cache ถูกตัดขนาดลงเกิน 90%! ช่วยให้ Multi-GPU Cluster สามารถเปิดรับ Context ความยาว 64K-128K หรือรองรับ Concurrency ผู้ใช้พร้อมกันหลายร้อยคนได้โดย VRAM ฝั่ง KV Cache ไม่เต็ม OOM
MoE Expert Quantization Caveats
การทำ Quantization บนโมเดล MoE มีความคล้ายและแตกต่างจาก Dense Model:
- FP8 (E4M3 / E5M2): เป็นเกรดมาตรฐานทองคำสำหรับ DeepSeek-V3/R1 ให้คุณภาพแทบจะ 100% และรันตรงบน Tensor Core ของ H100 / B200 / RTX 4090
- 4-bit (AWQ / GGUF IQ4_XS): บีบอัดลงมาเหลือ ~350 GB VRAM ทำให้ยัดลงการ์ด 8x RTX 3090/4090 (192GB-256GB VRAM) ร่วมกับ Offloading ได้ แต่ต้องระวังอาการ Expert Routing Drift เพราะหาก Router หั่นบิตต่ำเกินไป Token อาจถูกส่งไปผิด Expert ส่งผลให้โมเดลตอบหลุดกรอบ
แนวทางการจัด Cluster ฮาร์ดแวร์
- Enterprise Production Cluster (8x H100 / 8x H200 80GB-141GB): รัน FP8 Native โดยใช้ EP=8 บน High-Speed NVLink Network ให้ Throughput สูงสุดระดับ Production 24/7
- Workstation / Local Budget Cluster (8x RTX 4090 24GB หรือ Mac Cluster): ใช้ 4-bit Quantization (IQ4 / AWQ) ร่วมกับ CPU / NVMe Expert Offloading บน vLLM หรือ SGLang เหมาะสำหรับการทดลองหรือใช้งานภายในองค์กรขนาดเล็ก
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ