LOCAL LLM FIELD GUIDE
Quantization: ลด VRAM ตรงไหน และแลกคุณภาพอย่างไร
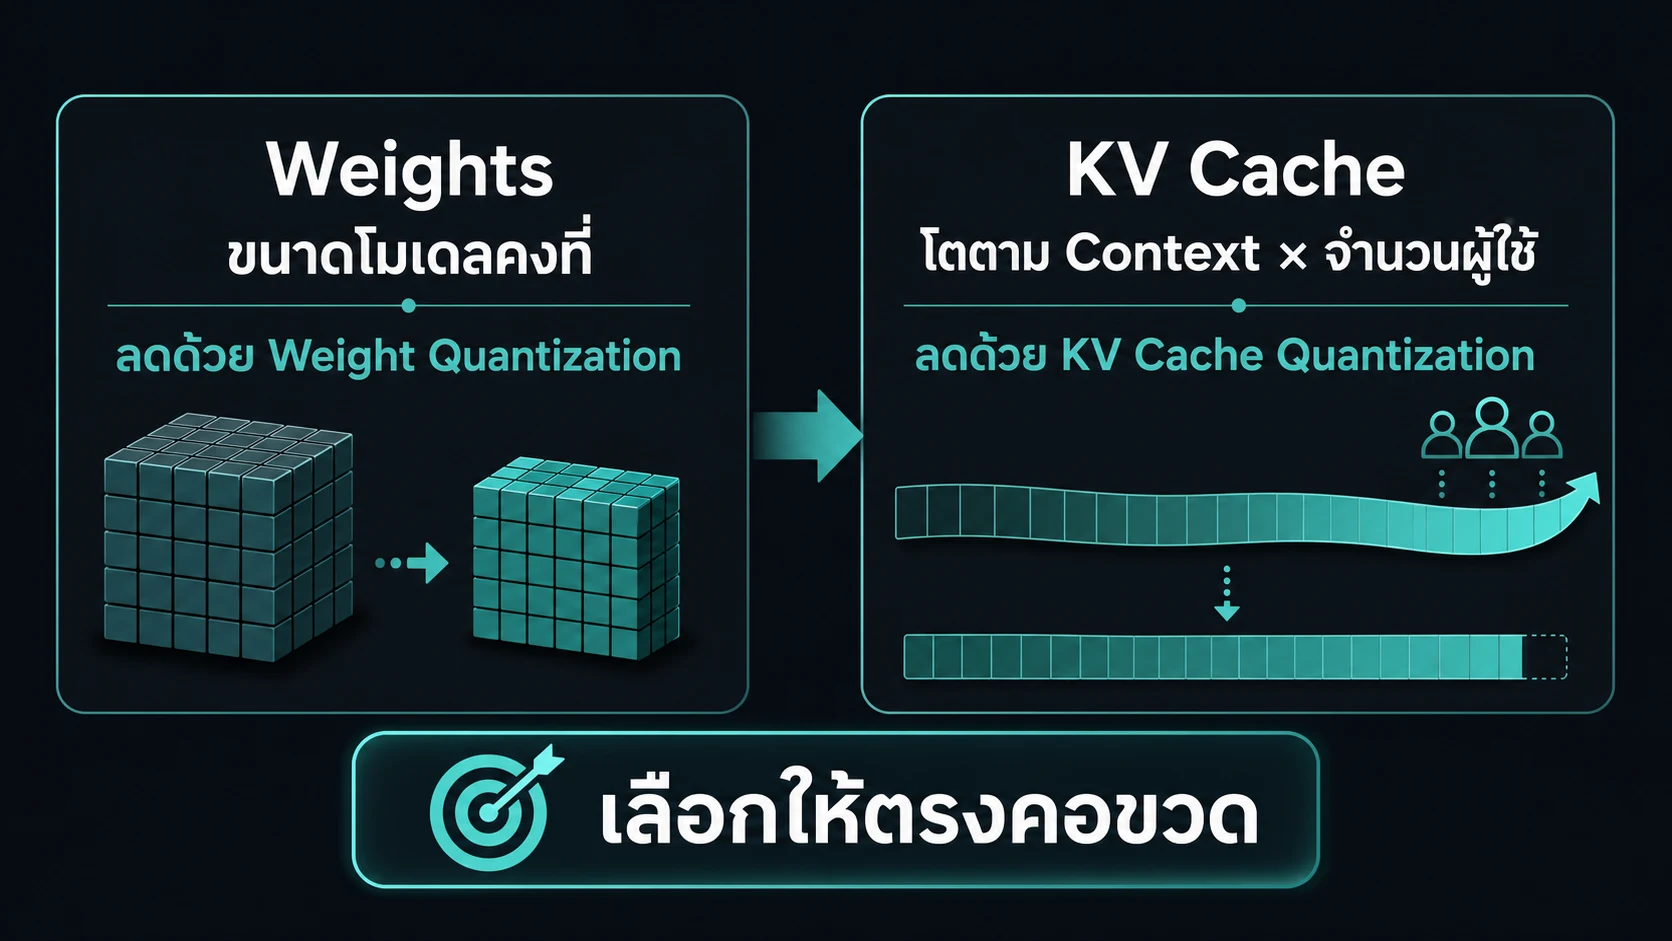
ย้ายโมเดล LLM มารันในเครื่องตัวเอง (Local) หรือลง GPU Server สิ่งแรกที่ต้องเจอคือปัญหากระดาษซับน้ำตา: VRAM (แรมการ์ดจอ) ไม่พอ! ทางออกยอดฮิตคือการทำ Quantization (การบีบอัดตัวเลขหรือลดทศนิยมของโมเดล) แต่หลายคนมักเข้าใจผิดว่า 4-bit จะลด VRAM รวมลงครึ่งหนึ่งเสมอ ในความเป็นจริง VRAM ถูกแบ่งออกเป็น 3 ก้อนหลัก ได้แก่ Model Weights (น้ำหนักสมอง AI), KV Cache (สมุดโน้ตจำบริบทที่คุย) และ Runtime Overhead (ค่าเปิดระบบ) การกดบิตฝั่ง Weights ช่วยให้โหลดโมเดลใหญ่ขึ้นได้ ในขณะที่การกดบิตฝั่ง KV Cache ช่วยให้ยัด Context ยาวๆ หรือรับหลายคนพร้อมกันได้โดยไม่ทำให้แรมระเบิดกลางคัน
สองก้อนที่ต้องแยก
weights อยู่คงที่ KV cache โตตามงาน
- Weights
- ลด model footprint และ bytes read ต่อ token
- KV cache
- ลด memory ต่อ context × sequence
ใช้กับงานจริง
ใช้ quant เพื่อแก้คอขวดที่ถูกจุด
เริ่มจาก runtime ที่จะรันจริง แล้วจึงเลือก artifact และจำนวนบิต การลด weights กับการลด KV cache แก้ปัญหาคนละก้อน จึงต้องดู memory breakdown แยกกัน
4-bit weight ลดก้อน model ได้มากกว่า 8-bit KV เป็นจุดเริ่มที่ปลอดภัยกว่าสำหรับ context ยาว QAT และ MXFP4 ต้องมี artifact และเส้นทาง runtime ที่ตรงกัน
| อาการ | สิ่งที่ควรปรับ | ตรวจให้ชัด |
|---|---|---|
| weights ไม่พอดี memory | ลด weights จาก 8-bit เป็น 4-bit ที่ runtime รองรับ | checkpoint, kernel และ eval งานจริง |
| context ยาวแล้ว KV เต็ม | เริ่มจาก FP8 หรือ INT8 KV ก่อน 4-bit KV | KV ต่อ sequence และ long-context retrieval |
| งานคุณภาพสำคัญ | เลือก QAT 4-bit หรือ 8-bit weights ถ้ามีพอดี | reasoning, tool call, JSON และภาษาไทย |
| ต้องใช้ MXFP4 | ใช้ native MXFP4 checkpoint กับ kernel และ hardware ที่รองรับ | mode ที่โหลดจริง ไม่ใช่แค่ชื่อ Q4 |
| ใช้ Mac | เลือก MLX หรือ GGUF/Metal path | artifact ที่แปลงมาสำหรับ runtime นั้น |
เช็กก่อนลดจำนวนบิต
- บันทึก
runtime, รุ่น runtime และ checkpoint ที่ใช้ - แยก
weight quantออกจากKV cache dtype - ตั้ง
working contextจาก request ปกติ ไม่ใช่เพดานสูงสุด - เทียบ baseline กับ 4-bit หรือ 8-bit โดยใช้ prompt, context, batch และ sampling เดียวกัน
- ทดสอบ grounded answer, tool call และ structured output ก่อน deploy
runtime = vllm
weight_format = QAT_W4A16
kv_cache_dtype = fp8_e4m3
working_context = 32768
compare_to = weight_q8 + kv_bf16
Weights กับ KV cache เป็นคนละงบ
เวลาเราเห็นโมเดลขนาด 70B โครงสร้างน้ำหนัก (Weights) ตอนเป็น FP16 หรือ BF16 จะกินพื้นที่บน VRAM สูงถึงเกือบ 140 GB ซึ่งการ์ดจอชาวบ้านอย่าง RTX 3090/4090 (24 GB) หมดสิทธิ์แตะต้องโดยสิ้นเชิง แต่ปัญหาคือ หลายคนคิดว่าพอทำ 4-bit แล้ว VRAM จะเหลือแค่ 35 GB แล้วจบเลย ซึ่งในความเป็นจริงนั่นเป็นความเข้าใจผิดที่ทำให้หลายคนเจออาการ OOM (Out of Memory) ตอนรันจริง!
วิธีคิดงบ VRAM ที่ถูกต้องในทางวิศวกรรม ต้องแยกพื้นที่ออกเป็น 4 ส่วนชัดเจน:
- Model Weights (ขนาดคงที่): เป็นพื้นที่สำหรับเก็บตัวเลขน้ำหนักสมองของ AI ก้อนนี้จะคงที่ตลอดเวลาตั้งแต่เริ่มโหลดเซิร์ฟเวอร์ ถ้าก้อนนี้ใหญ่เกิน VRAM การ์ดจอ เซิร์ฟเวอร์จะล้มตั้งแต่ยังไม่ทันเริ่มรัน (Boot Failed)
- KV Cache (ขนาดแปรผันตาม Traffic): เป็นความจำชั่วคราวของ Attention Context ที่เก็บ Key-Value states ของทุก Token ที่เข้าและออกจากระบบ ก้อนนี้ไม่ได้คงที่ แต่จะขยายตัวตามจำนวน Context (Context Length) และจำนวน Request ที่เข้ามาพร้อมกัน (Batch Size / Concurrency) ยิ่งคุยยาว ยิ่งยูสเซอร์เยอะ ก้อนนี้จะกินแรมมหาศาล
- Runtime & Activation Overhead (ค่าต๋งระบบ): พื้นที่สำหรับ CUDA Context, PagedAttention metadata, NCCL communications buffer และ Scratchpad สำหรับคำนวณ Tensor Core ซึ่งในเซิร์ฟเวอร์อย่าง vLLM หรือ TensorRT-LLM มักจะจองไว้ล่วงหน้า 1.5-3.5 GB
- Draft Model (ถ้าใช้ Speculative Decoding): พื้นที่เพิ่มเติมกรณีใส่ตัวเดา Token ล่วงหน้าเพื่อเร่งความเร็ว
การเข้าใจความแตกต่างนี้สำคัญมาก เพราะการ Quantize ฝั่ง Weights จะช่วยแก้คอขวดด่านแรก (ทำให้โมเดลใหญ่พอดีการ์ด) ส่วนการ Quantize ฝั่ง KV Cache จะช่วยแก้คอขวดด่านสอง (ทำให้รับคนเยอะๆ หรืออ่านเอกสารยาวๆ ได้โดยแรมไม่เต็ม)
4-bit กับ 8-bit ฝั่ง model weights
ถ้านำโมเดล 32B อย่าง Qwen 3.6 มาเปรียบเทียบ การรันที่ 8-bit (INT8 หรือ FP8) จะใช้ VRAM ฝั่ง Weights ประมาณ 33-35 GB ซึ่งต้องใช้การ์ดระดับ RTX 6000 Ada หรือ A100/H100 เท่านั้น แต่พอย่อยลงมาเหลือ 4-bit (INT4 / AWQ / GGUF Q4_K_M) ขนาด Weights จะฮวบลงมาเหลือเพียงประมาณ 18-20 GB ทำให้สามารถยัดลงการ์ดระดับ 24 GB อย่าง RTX 3090/4090 หรือ RTX 5090 ได้ทันที!
อย่างไรก็ตาม ตัวเลขบิต ไม่ใช่คำตอบเดียวของประสิทธิภาพและคุณภาพ:
- 8-bit (FP8 / INT8): ใช้ VRAM ฝั่ง Weights เป็นสองเท่าของ 4-bit แต่ข้อดีระดับช้างสารคือ มันสามารถรักษาความแม่นยำด้านเหตุผล (Reasoning), การเขียนโค้ดภาษาซับซ้อน, และการดึงข้อมูลจาก Document ยาวๆ ได้เกือบ 99% เท่ากับ BF16 ดั้งเดิม แถมยังมี Outlier Weight Protection ที่เสถียรกว่ามาก
- 4-bit (INT4 / AWQ / GPTQ): ลดขนาดแรมลงได้มหาศาล เปิดโอกาสให้คนงบน้อยสามารถรันโมเดลฉลาดระดับ 32B-70B บนการ์ดระดับ Consumer ได้ แต่สิ่งที่ต้องแลกคือ ความเสี่ยงเรื่องอาการหลอน (Hallucination) ที่เพิ่มขึ้นเล็กน้อยใน Edge Cases และคุณภาพความจุภาษาที่ขึ้นอยู่กับเทคนิค Quantization, Group Size (เช่น group-128 vs group-64) และคุณภาพของ Calibration Dataset ที่นำมาใช้ปรับแต่ง
4-bit weight มีหลาย family
อย่าเพิ่งสรุปว่า ไฟล์ 4-bit แบรนด์ไหนก็เหมือนกันหมด เพราะในโลกของวิศวกรรม AI คำว่า 4-bit มีตระกูล (Families) และปรัชญาการบีบอัดที่แตกต่างกันอย่างสิ้นเชิง:
- AWQ (Activation-aware Weight Quantization): ปรัชญาของ AWQ คือ Weight ทุกตัวในสมองไม่ได้สำคัญเท่ากัน AWQ จะสังเกตว่าตอนรันจริง แชนเนลไหนที่มี Activation สูงเป็นพิเศษ มันจะรักษา Weight บริเวณนั้นไว้ไม่ให้สูญเสียความแม่นยำ ทำให้ AWQ ขึ้นชื่อเรื่องความสมดุลระหว่างความเร็วและคุณภาพในตระกูล Post-Training Quantization (PTQ) บน vLLM และ SGLang
- GPTQ & AutoRound: GPTQ ใช้คณิตศาสตร์ระดับ Layer-wise Hessian Optimization เพื่อปัดเศษค่า Weight ให้เกิด Error รวมน้อยที่สุด ส่วน AutoRound เป็นเทคนิคขั้นกว่าที่ใช้ Sign-Gradient Descent ปรับรอบการปัดเศษร่วมกับข้อมูล Calibration ทำให้ลดอัตราหลอนในตระกูล 4-bit ได้ดีเยี่ยม
- QAT (Quantization-Aware Training): นี่คือ จอกศักดิ์สิทธิ์ ของ 4-bit เพราะมันไม่ใช่การนำโมเดลเกรดเต็มมาหั่นฉับหลังฝึกเสร็จ (PTQ) แต่เป็นการฝึกฝน (Training/Fine-tuning) โดยใส่แบบจำลองการปัดเศษ 4-bit เข้าไปตั้งแต่แรก ทำให้โมเดลเรียนรู้ที่จะชดเชยค่าความคลาดเคลื่อนด้วยตัวเอง ผลลัพธ์คือ QAT 4-bit ให้คุณภาพแทบไม่ต่างจาก FP16! (ตัวอย่างเช่น Gemma 4 QAT)
- NVFP4 & MXFP4 (Microscaling Formats): นวัตกรรมใหม่ล่าสุดจาก NVIDIA Blackwell และมาตรฐาน OCP โดยเก็บข้อมูลเป็น FP4 E2M1 ร่วมกับ Block Scale แบบย่อย (เช่น 1 Scale ต่อ 32 ค่า) ซึ่งรันตรงบน Tensor Core รุ่นใหม่ได้ความเร็วแบบติดเทอร์โบ
ดังนั้น เวลาเลือกใช้ 4-bit อย่าดูแค่คำว่า 4-bit แต่ต้องดูว่ามันเป็น Artifact จาก Family ไหน และเอนจินที่จะนำไปรัน (vLLM / llama.cpp / MLX) มี Kernel สปีดตรงตระกูลนั้นหรือไม่
GGUF คือ container สำหรับ llama.cpp ไม่ใช่ชื่อ quant เดียว
ในวงการสายรัน LLM บนคอมพิวเตอร์ส่วนบุคคล (Mac / PC / Laptop) ชื่อที่ได้ยินบ่อยที่สุดคงหนีไม่พ้น GGUF แต่โปรดจำไว้ว่า GGUF ไม่ใช่ชื่ออัลกอริทึมการบีบอัด! GGUF คือ Binary Container Format ของโปรเจกต์ GGML / llama.cpp ที่ทำหน้าที่ยัดเอาทั้งน้ำหนักโมเดล, โครงสร้าง สเปก และ Tokenizer Metadata มารวมไว้ในไฟล์เดียว (.gguf) เพื่อให้ลากไปวางแล้วรันได้ทันที
ภายในไฟล์ GGUF เดียวกัน จะมีระดับ Quantization ให้เลือกย่อยอย่างละเอียดตามงบแรมของคุณ:
- Q4_K_M (Medium 4-bit): เป็นจุดเริ่มต้น พิมพ์นิยม ที่สมดุลที่สุดสำหรับงานทั่วไป ใช้เทคนิค K-quants โดยแยก Quantize ชั้นสำคัญ (Attention & Feed-Forward) ด้วยบิตที่ต่างกัน ให้คุณภาพดีมากเมื่อเทียบกับขนาดไฟล์
- Q5_K_M / Q6_K: เหมาะสำหรับคนที่พอมี headroom VRAM เหลือ แล้วต้องการความมั่นใจสูงในงานภาษาไทย งานเขียนโค้ด หรือวิเคราะห์ข้อความซับซ้อน โดยยอมจ่าย VRAM เพิ่มขึ้นอีก 20-30%
- Q8_0: แทบจะถอดแบบความแม่นยำมาจาก FP16 ดั้งเดิม เหมาะสำหรับการนำไปทำ Benchmark หรือรันงานที่ห้ามผิดพลาดเลย
ข้อควรรู้คือ ขนาดบิตจริง (Effective Bits per Weight) ของไฟล์ GGUF มักจะไม่ใช่ 4.00 บิตเป๊ะๆ เพราะต้องรวมพื้นที่เก็บ Scale, Min-values และ Tensor ชั้นแรก/ชั้นสุดท้ายที่ไม่ได้ถูก Quantize ด้วย และที่สำคัญที่สุด: ควรโหลดไฟล์ GGUF ที่แปลงมาจากสเปกต้นฉบับ BF16/FP16 ของผู้พัฒนา (เช่น Unsloth) เสมอ ไม่ควรใช้ไฟล์ที่เกิดจากการ Re-quantize ข้ามไปข้ามมาจากไฟล์ low-bit อื่นเพราะจะทำให้คุณภาพเสื่อมถอยอย่างรุนแรง
4-bit กับ 8-bit ฝั่ง KV cache
เมื่อไหร่ที่คุณรันระบบแล้วเจอสถานการณ์ที่ว่า ตอนเริ่มรันแรมก็เหลือเยอะดี แต่พอคุยไปถึง 32K context หรือพอยูสเซอร์กดเข้ามาพร้อมกัน 10 คน แรมการ์ดจอก็ตีขึ้น 100% จน OOM ทันที นั่นคือสัญญาณเตือนว่าคุณกำลังโดน KV Cache กินเมือง!
โดยปกติ เซิร์ฟเวอร์จะเก็บ KV Cache ในรูปแบบ FP16 หรือ BF16 (2 Bytes ต่อ Element) ซึ่งถ้าเราปรับเทคนิค KV Quantization:
- FP8 / INT8 KV Cache (บีบอัดลง 50%): เปลี่ยนการเก็บ Key-Value states ให้เหลือเพียง 1 Byte ต่อ Element วิธีนี้ช่วยตัดขนาด VRAM ฝั่ง KV Cache ลงได้เกือบครึ่งหนึ่งทันที! ที่สำคัญคือ อัตราความคลาดเคลื่อนต่ำมาก จนแทบมองไม่เห็นความต่างในงานประมวลผลทั่วไป เป็นตัวเลือก เซฟตี้เฟิร์สท์ ที่ควรเปิดใช้เป็นด่านแรกบน vLLM, SGLang หรือ TensorRT-LLM
- 4-bit / INT4 KV Cache (บีบอัดลง ~70-75%): หั่นพื้นที่ KV ลงเหลือประมาณ 0.5 Byte ต่อ Element ช่วยให้คุณประหยัดแรมมหาศาลจนสามารถยัด Context ระดับ 128K หรือรับ Concurrency หลายสิบคนบนการ์ดจอใบเดียวได้อย่างน่าทึ่ง แต่วิธีนี้ต้องแลกด้วยความเสี่ยงเรื่อง Attention Accuracy ในระยะทางบริบทไกลๆ (Long-context Retrieval Drift) จึงต้องทดสอบกับชุดคำถามจริงก่อนนำไปใช้ใน Production
สิ่งที่ต้องย้ำคือ การทำ KV Quantizationไม่ได้ช่วยลดขนาดไฟล์โมเดล (Model Weights) เลยแม้แต่ megabyte เดียว แต่มันคือสวิตช์ลับที่ทำให้ระบบรันบริบทได้ยาวขึ้นอย่างก้าวกระโดด!
QAT คือ checkpoint ที่ฝึกให้รับ quantization
ในอดีต เวลาเราอยากได้โมเดล 4-bit เราจะนำโมเดลเกรดเต็ม (FP16/BF16) มาทำ Post-Training Quantization (PTQ) ซึ่งเปรียบเหมือนการเอาสมองมนุษย์มาผ่าตัดลดขนาดเส้นเลือดกะทันหัน ทำให้สมองบางส่วนสูญเสียฟังก์ชันการคิดไปอย่างหลีกเลี่ยงไม่ได้
แต่ QAT (Quantization-Aware Training) คือนวัตกรรมที่เข้ามาเปลี่ยนเกม! ในระหว่างขั้นตอนการฝึก (Training) หรือ Fine-tuning ทีมวิศวกรจะใส่ตัวจำลองความคลาดเคลื่อนของการปัดเศษแบบ 4-bit เข้าไปในสมการ Fake Quantization ด้วย ผลลัพธ์คือ ตัวโมเดลจะเรียนรู้ที่จะปรับตัว ชดเชยความผิดพลาด และจัดวางโครงสร้าง Weight ให้ทนทานต่อการบีบอัดระดับ 4-bit ตั้งแต่เกิด!
โมเดลที่ผ่านการ QAT (เช่น Google Gemma 4 QAT หรือ DeepSeek QAT Releases) จึงสร้างปรากฏการณ์ใหม่: สามารถบีบอัดลงมาเหลือ 4-bit ได้โดยที่คะแนนวัดผล Benchmarks และความแม่นยำด้านโครงสร้างข้อความรักษาระดับได้ใกล้เคียงกับต้นฉบับ BF16 ถึง 98-99% อย่างไรก็ตาม QAT ไม่ใช่สวิตช์ที่คุณจะไปสั่งให้เอนจินรันเดี๋ยวนั้นได้ แต่มันต้องเริ่มจากการเลือกใช้ QAT Checkpoint Repo ที่ทางค่ายผู้พัฒนาปล่อยออกมาโดยตรงเท่านั้น
QAT W4A16 vs NVFP4: เลือกแบบไหนให้เหมาะกับงานและฮาร์ดแวร์
ในการเลือกใช้ 4-bit ต้องแยกแยะมิติของเทคโนโลยีออกเป็น 2 แกนหลักเพื่อไม่ให้สับสน:
- QAT (Quantization-Aware Training): เป็นวิธีฝึกโมเดลโดยใส่ Fake Quantization เพื่อให้ Weight ปรับตัวชดเชย Error
- W4A16 vs W4A4 (Precision Format): W4A16 เก็บ Weight 4-bit แต่คง Activation ไว้ที่ 16-bit (FP16/BF16) ส่วน W4A4 บีบอัดทั้ง Weight และ Activation เป็น 4-bit
- NVFP4 (NVIDIA Microscaling FP4): ชนิดข้อมูล FP4 E2M1 ร่วมกับ FP8 Block Scale (1 Scale ต่อ 16 ค่า) ออกแบบมาสำหรับ NVIDIA Blackwell / Hopper Tensor Cores
ดังนั้น Checkpoint เดียวกัน สามารถเป็นทั้ง QAT + W4A16 + NVFP4 Weights ร่วมกันได้ (เช่น w4a16_nvfp4 ใน NVIDIA ModelOpt)
คำแนะนำการเลือกใช้งานตามค่าย ฮาร์ดแวร์ และ Workload:
- รันบน NVIDIA GPUs (Blackwell / Ada / Hopper): หากมี Official NVIDIA NVFP4 Checkpoint (เช่น Gemma 4 26B-A4B nvfp4_experts_only หรือ Qwen 3.6 NVFP4) เลือก NVFP4 ได้เลย เพราะมีการเลือก Quantize เฉพาะชั้น Expert โดยเว้น Attention/Router ไว้ จึงได้ Prefill Speed และ Concurrency Throughput สูงโดยคุณภาพตกเพียง 0.1-0.6 คะแนน
- งาน Single-user Terminal Coding / Tool-calling JSON: ในงาน Single-user (Batch Size = 1) ความเร็ว Decode tok/s ของ W4A16 และ W4A4 ใกล้เคียงกันเพราะติดคอขวดที่ Memory Bandwidth ข้ามแรม แต่ QAT W4A16 จะรักษาความแม่นยำ Pass@1 และป้องกัน Activation Outliers ได้ปลอดภัยกว่า
- รันบนค่ายอื่น (AMD ROCm, Mac Apple Silicon): ควรเลือก QAT W4A16, AWQ หรือ GGUF Q4_K_M เพราะการคง Activation 16-bit ช่วยหลีกเลี่ยงความเสี่ยง Activation Outlier Drift บนฮาร์ดแวร์ที่ไม่มี Native FP4 Execution Units
MXFP4 ไม่ใช่ INT4 ทั่วไป
อย่าสับสนระหว่าง INT4 ในอดีตกับ MXFP4 (Microscaling FP4) ที่เป็นมาตรฐานอุตสาหกรรมยุคใหม่จาก Open Compute Project (OCP)
ในสถาปัตยกรรมแบบเดิม INT4 จะเก็บบิตเป็นจำนวนเต็มสเกลาร์เดี่ยวๆ ซึ่งช่วงกว้างการรับตัวเลข (Dynamic Range) ค่อนข้างแคบ แต่ MXFP4 ใช้รูปแบบชนิดข้อมูล floating-point แบบ FP4 E2M1 (2 bits exponent, 1 bit mantissa) ร่วมกับเทคนิค Block Microscaling โดยในทุกๆ 32 ค่าตัวเลข จะมีตัวแชร์ค่าสเกล E8M0 Scale ร่วมกัน 1 ตัว
เมื่อคิดคำนวณพื้นที่รวม Scale แล้ว MXFP4 จะใช้พื้นที่จริงประมาณ 4.25 bits ต่อ Weight ซึ่งมีข้อดีมหาศาลดังนี้:
- Dynamic Range กว้างกว่า INT4: สามารถเก็บค่าบวก/ลบที่มีความผันผวนสูง (Outliers) ได้ดีกว่า ทำให้คุณภาพผลลัพธ์ฉลาดกว่า INT4 ทั่วไปในขนาดไฟล์ที่เท่ากัน
- Hardware Native Accelerator: ถูกออกแบบมาให้รันกับ Tensor Core ยุคใหม่อย่าง NVIDIA Blackwell (NVFP4 / modelopt_fp4) และ AMD Instinct / RDNA4 ด้วยความเร็วกระฉูด
อย่างไรก็ตาม การจะรัน MXFP4 ให้ได้สปีดและความแม่นยำสูงสุด คุณต้องมีองค์ประกอบครบทั้ง 3 ด่าน: Checkpoint ที่เป็น Native MXFP4, Runtime Backend ที่มี Kernel ตรงรุ่น (เช่น vLLM / SGLang / MLX), และ ฮาร์ดแวร์ที่มี Instruction Set รองรับ
เลือก artifact ให้ตรง runtime
- Mac Apple Siliconใช้ MLX model ที่แปลงมาโดยตรงสำหรับ MLX หรือใช้ไฟล์ GGUF ผ่าน llama.cpp บน Metal MXFP4 ใช้ได้เมื่อ MLX artifact และรุ่นที่เลือกมี path รองรับ
- llama.cpp / Ollamaใช้ไฟล์ GGUF เช่น Q4_K_M, Q5_K_M หรือ Q8 ใช้ได้กับ CPU, Metal และ backend GPU ที่ llama.cpp รองรับ
- vLLM / SGLangเลือก Hugging Face checkpoint และ loader ที่รองรับ เช่น AWQ, GPTQ, AutoRound, QAT compressed-tensors หรือ native FP4 FP8 KV ที่ calibrate ตาม model ช่วยลด error ได้
- GGUF บน vLLMvLLM โหลด GGUF ได้ในบางกรณี แต่เอกสารระบุว่าเป็น experimental และยัง under-optimized ไม่ควรใช้เป็น default สำหรับ server feature ครบหรือ performance-sensitive
อย่าเลือกจากชื่อ quant อย่างเดียว: Q8, QAT, MXFP4, AWQ, GPTQ และ GGUF เป็นคนละชนิดของ artifact หรือ format ตรวจ model, runtime, hardware และ kernel ให้ตรงกันทุกครั้ง
คุณภาพและอาการหลอน
ความจริงที่คนทำงาน AI ต้องยอมรับคือ: การ Quantize ไม่เคยทำให้โมเดลฉลาดขึ้น มีแต่เท่าเดิมหรือแย่ลง
อาการหลอน (Hallucination) หรือการตอบผิดไม่ได้เกิดจาก Quantization เพียงอย่างเดียว แต่อาจมาจากคุณภาพข้อมูลตอนฝึก, Prompt ที่คลุมเครือ, หรือการตั้งค่า Sampling (Temperature / Top-P) ที่กว้างเกินไป ทว่าการหั่นบิตน้ำหนักโมเดลลงมาเหลือ 4-bit จะเพิ่มสิ่งที่เรียกว่า Quantization Noise Error ซึ่งส่งผลกระทบในงานจริงดังนี้:
- Structured Output พัง: โมเดลอาจจะเริ่มหลุดฟอร์แมต JSON, ปิดปีกกาไม่ครบ, หรือเจนฟิลด์ผิดสเปก
- Tool Calling ผิดพลาด: การแกะอาร์กิวเมนต์เพื่อเรียกใช้ Function/API อาจจะมีชื่อพารามิเตอร์เพี้ยนหรือส่งค่า NULL ไปมั่วๆ
- Reasoning Drift ในโจทย์ซับซ้อน: สำหรับโจทย์คณิตศาสตร์ โค้ดดิ้ง หรือคำถามภาษาไทยที่มีไวยากรณ์ซับซ้อน โมเดลระดับ 4-bit แบบ PTQ ทั่วไปจะมีอัตราตอบหลุดกรอบสูงกว่า FP16 อย่างเห็นได้ชัด
- Long-context Retrieval Miss: หากใช้ KV Cache แบบ 4-bit ร่วมด้วย ความสามารถในการค้นหาข้อมูลสำคัญที่ซ่อนอยู่กลางเอกสารยาวๆ (Needle in a Haystack) จะลดลงอย่างมีนัยสำคัญ
ดังนั้น อย่าปักใจเชื่อเพียงเพราะคะแนน MMLU หรือ Benchmark เฉลี่ยบนกระดาษดูดี แต่ให้ทดสอบกับ Real Workload Prompt ของคุณเองก่อนตัดสินใจสเกลระบบเสมอ
ใช้ calculator อย่างถูกลำดับ
เพื่อการวางแผนระบบ (Capacity Planning) ที่แม่นยำและไม่เจ็บตัวทีหลัง แนะนำให้ใช้ LLM VRAM Calculator ตามลำดับขั้นตอนวิศวกรรมดังนี้:
- Lock Hardware & Framework: เลือกการ์ดจอ/คอมพิวเตอร์ และ Serving Framework ที่คุณจะรันจริงก่อนเป็นอันดับแรก (เช่น RTX 4090 24GB + vLLM)
- วิเคราะห์ Memory Breakdown: ดูผลลัพธ์ในคำนวณว่า VRAM ตันที่ก้อนไหน:
- หากเปิดเซิร์ฟเวอร์ไม่ขึ้นหรือแรมเต็มตั้งแต่เริ่ม แสดงว่าปัญหาอยู่ที่ Model Weights ให้ลองปรับ Weight Quantization จาก FP16 เป็น 8-bit หรือ 4-bit (AWQ / QAT / GGUF)
- หากโหลดโมเดลผ่านแต่พอรัน Context ยาวหรือรับคนเพิ่มแล้วแรมระเบิด แสดงว่าปัญหาอยู่ที่ KV Cache ให้ลองปรับ KV Cache Quantization เป็น FP8 หรือ INT8
- ทดสอบ Benchmark แบบส้มชนส้ม: หลังเลือกค่าที่แรมพอดีในเครื่องมือแล้ว ให้รันระบบทดสอบจริงโดยล็อคค่า Prompt, Context Length, Batch Size และ Sampling ให้เหมือนกันทุกประการ แล้ววัดผลทั้ง 3 มิติ: VRAM Peak, Speed (TTFT / tok/s), และ Accuracy (Grounded Answers / JSON Validity) ก่อนนำระบบขึ้น Production จริง!
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ