LOCAL LLM FIELD GUIDE
ทำไม tok/s ของ LLM มักติด Memory Bandwidth
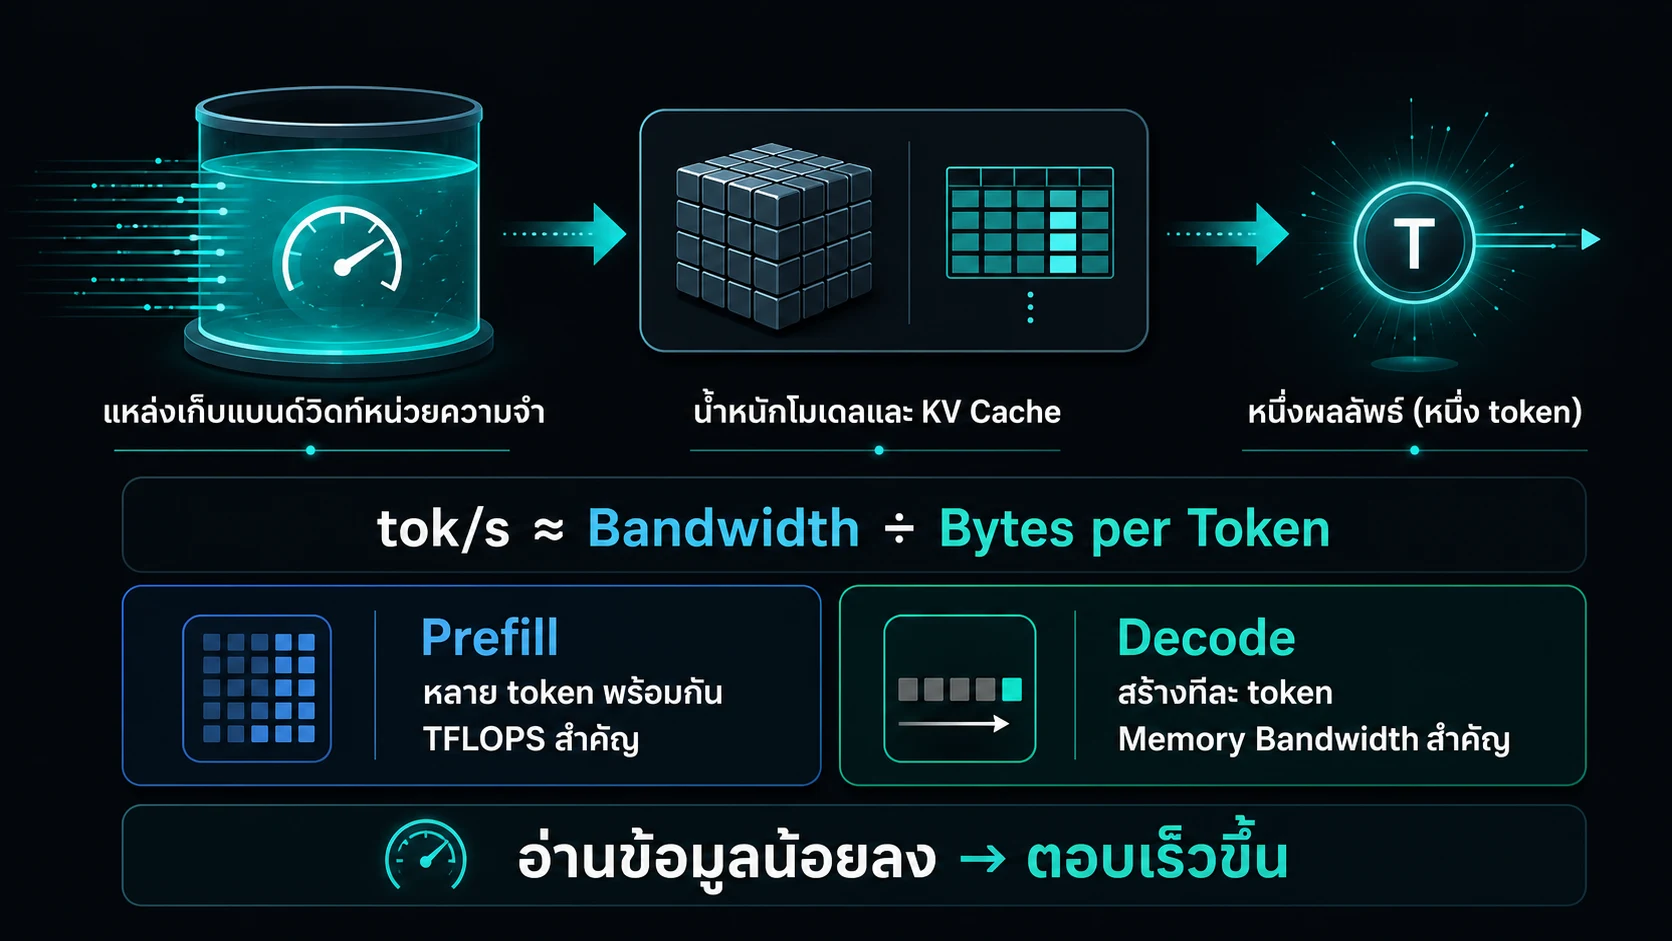
เวลารันโมเดล LLM หลายคนมักถามว่า ทำไม GPU เรามี TFLOPS ตั้งเยอะ แต่รัน Decode ได้ความเร็วแค่ไม่กี่สิบ tok/s? คำตอบซ่อนอยู่ใน Roofline Model: ในช่วง Decode การสร้าง Token แต่ละตัว ตัวเซิร์ฟเวอร์ต้องโหลดน้ำหนักสมอง (Model Weights) ทั้งหมดหลายสิบ gigabytes ผ่านสายส่งแรม (Memory Bandwidth) ซ้ำแล้วซ้ำเล่าเพื่อสร้างคำเพียงคำเดียว! ทำให้คอขวดหลักไม่ได้อยู่ที่ความเร็วในการคำนวณ (Compute FLOPS) แต่อยู่ที่ความเร็วในการเคลื่อนย้ายข้อมูล (Data Transfer Bandwidth)
ROOFLINE PERFORMANCE MODEL
สูตรนี้เป็น model สำหรับวางแผน ไม่ใช่ benchmark
ให้คิดว่า tok/s เริ่มจากข้อมูลที่ hardware เคลื่อนย้ายได้ แล้วถูกปรับด้วยเส้นทาง software และจำนวน bytes ที่อ่าน
ทดลองเอง
Prefill กับ Decode: อะไรเป็นตัวจำกัดความเร็วจริง
สลับ Prefill กับ Decode แล้วเปลี่ยนฮาร์ดแวร์กับรูปแบบ weights เพื่อดูว่า decode ติด memory bandwidth อย่างไร ส่วน prefill ติด FLOPS อย่างไร ตัวเลขเป็นภาพสอนด้วยโมเดล 32B dense ตายตัว ไม่ใช่ผลจากเครื่องคำนวณ
ใช้กับงานจริง
อ่าน tok/s ให้ตรงกับสิ่งที่วัด
Decode สร้าง output ทีละ token จึงมักอ่าน weights และ KV cache ซ้ำ Prefill รับ prompt หลาย token พร้อมกันและมีคอขวดต่างกัน
ตัวเลขจาก calculator ใช้สำหรับจัดลำดับทางเลือก ใช้ benchmark เดียวกันยืนยันก่อนตัดสินใจเรื่อง latency, capacity หรือค่าใช้จ่าย
| ตัวชี้วัด | ใช้ตอบคำถาม | ไม่แทนค่า |
|---|---|---|
| TTFT | ผู้ใช้รอก่อน token แรกนานเท่าไร | ความเร็วระหว่าง generate |
| ITL | ช่วงห่างระหว่าง output token | เวลา prefill |
| output tok/s | ความเร็ว decode ของหนึ่ง request | aggregate throughput |
| peak memory | headroom ก่อน OOM | คุณภาพคำตอบ |
เงื่อนไขที่ต้องคงเดิมเมื่อเปรียบเทียบ
- model, quant และ runtime เดียวกัน
- working context และ batch เดียวกัน
- prompt, sampling และ power mode ใกล้กัน
- วัด TTFT, ITL, tok/s และ peak memory แยกกัน
readPerStepGB = (activeWeightsBytes + N * kvReadPerStreamBytes) / 1e9
tok/s_total = bandwidthGBps * frameworkEff * quantKernelEff
              * attentionEff * specMult(N) * N / readPerStepGB
Prefill กับ decode ใช้ GPU คนละแบบ
หนึ่งในสิ่งที่สร้างความสับสนมากที่สุดเวลาประเมินความเร็ว LLM คือ การเอาตัวเลข tok/s (Tokens per Second) ตัวเดียวมาอธิบายประสบการณ์การใช้งานทั้งหมด ทั้งที่ในความเป็นจริง สถาปัตยกรรม Transformer แบ่งขั้นตอนการทำงานออกเป็น 2 เฟสหลักที่ใช้ GPU แตกต่างกันอย่างฟ้ากับเหว:
- Prefill Phase (Prompt Processing): เป็นขั้นตอนที่เซิร์ฟเวอร์อ่านและประมวลผลคำถาม (Prompt) ทั้งหมดที่คุณส่งเข้าไปพร้อมกัน เนื่องจากสามารถรวมการคำนวณแบบ Matrix Multiplication (GEMM) ของหลายๆ Token เข้าด้วยกันได้ GPU จึงใช้ประโยชน์จาก Tensor Cores ได้อย่างเต็มประสิทธิภาพ เฟสนี้จึงมักติดคอขวดที่ Compute Bound (TFLOPS) Prompt ยาวๆ จึงทำให้เกิดเวลาการรอคอยคำแรก หรือ TTFT (Time to First Token) ที่สูงขึ้น
- Decode Phase (Token Generation): เป็นขั้นตอนการสร้างคำตอบออกมาทีละคำ (Autoregressive Generation) ในการสร้าง Token ถัดไปเพียง 1 ตัว GPU จำเป็นต้องกวาดอ่านน้ำหนัก (Weights) ทั้งหมดของโมเดลขนาดหลายสิบ GB บวกกับ KV Cache Memory ผ่านแรมการ์ดจออีกรอบ! งานตรงนี้เป็น Matrix-Vector Multiplication (GEMV) ซึ่งประมวลผลแมทริกซ์ขนาดเล็กมาก เฟสนี้จึงติดคอขวดที่ Memory Bandwidth Bound (GB/s) อย่างรุนแรง
นั่นคือเหตุผลที่ระบบ Chatbot อาจจะมี TTFT ช้าเล็กน้อยตอนอ่านเอกสารยาวๆ แต่พอเริ่มพ่นคำตอบคำแรกออกมาแล้ว Token จะไหลพรูอย่างรวดเร็ว
TTFT, TPOT, ITL และ E2E วัดคนละคำถาม
หากคุณรัน Production Server แล้วรายงานความเร็วให้ทีมฟังว่า เซิร์ฟเวอร์เราวิ่งได้เฉลี่ย 45 tok/s คุณกำลังละเลยประสบการณ์จริงของผู้ใช้ไปอย่างสิ้นเชิง! ในทางวิศวกรรม Inference Performance การวัดผล Latency ต้องแยกแยะ 4 ตัวชี้วัดสำคัญดังนี้:
- TTFT (Time to First Token): คือเวลาตั้งแต่ยูสเซอร์ส่งคำถาม จนกระทั่งเห็น Token แรกปรากฏบนหน้าจอ ตัวนี้รวมเวลาเข้าคิว (Queue Time) และเวลาประมวลผล Prefill Phase ทั้งหมด ถ้า TTFT ช้า ยูสเซอร์จะรู้สึกว่าระบบอืด ตอบสนองช้า
- TPOT (Time Per Output Token): คือเวลาเฉลี่ยในการสร้าง Token แต่ละตัวหลังจากคำแรกปรากฏแล้ว (สะท้อนถึง Decode Latency แท้จริง)
- ITL (Inter-Token Latency): คือช่วงเวลาห่างระหว่าง Token ติดกันขณะกำลัง Streaming ตัวนี้สำคัญมากสำหรับ UX เพราะค่าเฉลี่ย TPOT อาจดูดี แต่ถ้ามี ITL Spike (กระตุกสั้นๆ เป็นจังหวะจากการที่ Scheduler แทรกคำถามใหม่เข้ามา) ยูสเซอร์จะรู้สึกว่าข้อความอ่านแล้วชะงัก
- E2E Latency (End-to-End Latency): คือเวลารวมทั้งหมดตั้งแต่ส่งคำถามจนรับ Token ตัวสุดท้ายเสร็จสมบูรณ์
กฎทองของ Benchmark คือ: ต้องดูทั้งค่าเฉลี่ย Median (p50) และค่าหางยาวอย่าง p95 หรือ p99 ควบคู่กันเสมอ เพื่อไม่ให้ค่าเฉลี่ยสลวยมาหลอกตา!
Bytes per token คือแกนของ decode
สมการระดับแกนกลางของ Decode Speed ถูกกำหนดโดยแนวคิดเรื่อง Bytes Read per Token
ในแต่ละ Decode Step ปริมาณข้อมูลทั้งหมดที่ GPU ต้องอ่านข้ามผ่าน Memory Bus คำนวณได้จาก:
Bytes Read = Active Model Weights + (KV Cache per sequence * Active Sequences) + Attention Metadata
ยกตัวอย่างเช่น โมเดล 70B Quantized 4-bit (ขนาดไฟล์ ~35 GB) รันบนการ์ดจอที่มี Memory Bandwidth 1,000 GB/s (เช่น RTX 4090):
- ถ้าเปิดรัน 1 Request (Batch Size = 1) ในทางทฤษฎี GPU ต้องอ่านข้อมูล 35 GB เพื่อสร้าง 1 Token
- ความเร็ว Decode สูงสุดเชิงทฤษฎีจึงเท่ากับ: 1,000 GB/s / 35 GB = ~28.5 tok/s
นั่นคือเหตุผลว่าทำไมการทำ Weight Quantization จาก 8-bit เหลือ 4-bit จึงช่วยดันความเร็ว Decode ให้พุ่งขึ้นเกือบเท่าตัว! เพราะมันลดปริมาณ Bytes ที่ต้องกวาดอ่านในทุกๆ Step ลงไปครึ่งหนึ่งนั่นเอง
Context, output length และ concurrency เปลี่ยนจุดตัน
ลักษณะของ Workload หรือประเภทงานจะเปลี่ยนจุดคอขวด (Bottleneck) ของ GPU ไปโดยสิ้นเชิง:
- Prompt ยาว (Long Context RAG / Document Summary): งานประเภทนี้ทำให้ Prefill Workload หนักมาก ดัน TTFT สูง และกินพื้นที่ KV Cache ใน VRAM มหาศาล คอขวดจะย้ายไปอยู่ที่ Memory Capacity และ Compute FLOPS
- Output ยาว (Code Generation / Creative Writing): งานประเภทนี้ใช้ Decode Steps จำนวนมาก (เช่น 2,000+ tokens) คอขวดจะตกอยู่ที่ Memory Bandwidth เพียวๆ
- Concurrency สูง (Multi-user Enterprise Chatbot): พอยูสเซอร์ยิงเข้ามาพร้อมกันหลายสิบ Request ตัวเซิร์ฟเวอร์จะทำ Continuous Batching เพื่ออ่าน Weights ก้อนเดียวแล้วประมวลผลคำตอบให้หลายคนพร้อมกัน ซึ่งช่วยเพิ่ม Throughput รวม (Tokens/s ทั้งเซิร์ฟเวอร์) ให้สูงขึ้นจน GPU อิ่มตัว แต่มันจะเพิ่ม Queue Time, ดัน ITL ให้กระตุก และกิน KV Cache ใน VRAM จนเสี่ยง OOM!
Scheduler คือ tradeoff ไม่ใช่ปุ่มเร่งความเร็ว
ฟีเจอร์อย่าง Continuous Batching และ Chunked Prefill บนเอนจินยุคใหม่อย่าง vLLM หรือ SGLang ไม่ใช่ปุ่มเสกความเร็วฟรี แต่เป็นการบริหารความสัมพันธ์แบบ Tradeoff:
- Chunked Prefill: ช่วยสับ Prompt ยาวๆ ออกเป็นท่อนเล็กๆ แล้วแทรกเข้าไปประมวลผลพร้อมกับ Decode Steps ของ Request อื่น ข้อดีคือช่วยลดอาการ ITL Spike (ชะงักระหว่างพ่นคำตอบ) แต่ข้อเสียคือเพิ่ม Runtime Overhead และอาจทำให้ Throughput รวมของเซิร์ฟเวอร์ลดลงเล็กน้อย
- PD Disaggregation (Prefill-Decode Separation): แยก GPU เป็น 2 กลุ่มชัดเจน: กลุ่มหนึ่งรับหน้าที่ทำ Prefill (เน้น Compute) อีกกลุ่มรับหน้าที่ทำ Decode (เน้น Bandwidth) ข้อดีคือสามารถ Tune Performance ของทั้งสองเฟสได้อย่างอิสระ แต่ต้องแลกด้วยความซับซ้อนของการส่งมอบ KV Cache ผ่านเครือข่าย High-speed Network (เช่น NVLink / InfiniBand / RDMA)
อ่านผล estimate ของ calculator
เครื่องมือ LLM VRAM Calculator ใช้หลักการ Roofline Model โดยคำนวณ Decode tok/s จาก Memory Bandwidth ของฮาร์ดแวร์ แล้วนำมาคูณปรับแก้ด้วยค่าความเชี่ยวชาญของ Framework, Quantization Kernel, Attention Backend และ Speculative Decoding
ข้อควรระวังในการอ่านผลคำนวณ:
- ตัวเลขที่ได้เป็นการประมาณการความเร็วในสภาวะ Steady-state บนสถาปัตยกรรมฮาร์ดแวร์นั้นๆ
- เครื่องมือไม่ได้จำลองระบบคิวการจัดส่ง Request (Traffic Queueing), อัตราการรียูสสเปก (Prefix Cache Hit Rate), Thermal Throttling จากความร้อน, หรือ PCIe Bus Contention
- สำคัญที่สุด: เมื่อผลขึ้น OOM ต้องถือว่า tok per second เป็นค่าทางทฤษฎี ไม่ใช่ผลที่รันได้ เพราะในความเป็นจริง เซิร์ฟเวอร์จะ crash ล้มตั้งแต่ด่านแรก และไม่สามารถเปิดรันจริงได้เลย
ชุด benchmark ขั้นต่ำที่เทียบกันได้
- Interactive chatinput 512 or 2K tokens, output 128 tokens, concurrency 1 ดู TTFT, TPOT, ITL p95 และ memory peak
- Long contextinput 32K or context ที่ใช้งานจริง, output 128 tokens, concurrency 1 and 4 ดู TTFT, prefill throughput, KV memory และ quality
- Shared prefixsystem prompt or RAG prefix เดิม, many requests แยกผลที่มี prefix cache กับไม่มี cache
- Serving saturationarrival rate คงที่และเพิ่ม concurrency ทีละขั้น ดู output throughput, queue time, TTFT p95, ITL p95 และ error or OOM
- Speculative decodeprompt, sampling และ target เดิม เปิด and ปิด spec ดู acceptance, TTFT, ITL, output throughput และ peak memory
เก็บ configuration ให้ย้อนตรวจได้: บันทึก vLLM per-request metrics, checkpoint and quant artifact, tokenizer and chat template, runtime version, driver, flags, clock or power mode, GPU count และ traffic file ทุกครั้ง
ยืนยันด้วย workload
การทำ Benchmark ที่ถูกต้อง ต้องเริ่มต้นด้วยการรัน Warmup เพื่อเคลียร์ Caches จากนั้นทำการทดสอบหลายๆ รอบโดยใช้ชุด Prompt, Context Length, Concurrency และ Sampling ที่จำลองจากสภาพแวดล้อม Production จริง
โปรดรายงานผลแยกแยะระหว่าง Median (p50) และ p95/p99 ของทั้ง TTFT, ITL, Output Throughput และ Peak VRAM จงสรุปคอขวดของระบบด้วยหลักฐานทางตัวเลข ไม่ใช่เพียงแค่การอ้างชื่อรุ่นการ์ดจอหรือเลข tok/s ตัวเดียว!
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ