LOCAL LLM FIELD GUIDE
TensorFold คือเซิร์ฟเวอร์ Zig ที่เสิร์ฟโมเดลบน Metal และ CUDA
TensorFold เป็นเอนจินของ Ash Hart ภายใต้สัญญา Apache-2.0 ที่ github.com/ashhart/TensorFold ไบนารี Zig อ่าน checkpoint ตัด token และรันเคอร์เนล Metal หรือ CUDA เอง เส้นทางเสิร์ฟใน README ไม่ต้องติดตั้ง Python หรือ MLX ตัวอย่าง Linux ใน README ที่อ่านเมื่อ 2026-11-12 ปักรีลีส 1.2.7 ส่วนบันทึกการเปลี่ยนแปลงชี้โน้ต 1.0.0 เป็นจุดอธิบายไบนารีเนทีฟและการย้ายจากสูตรเก่า
NATIVE ZIG SERVER
ไบนารีอ่าน checkpoint แล้วเสิร์ฟเอง
- ตรวจแถวในตารางรีลีสก่อน ถ้าไม่มีแถวแสดงว่าไบนารีรีลีสยังไม่เสิร์ฟ
- ฟังที่ 127.0.0.1 จนกว่าจะตั้งใจเปิดพอร์ต
- เทียบโทเคนกับโหมดปิดดราฟต์บนเอนจินเดียวกัน
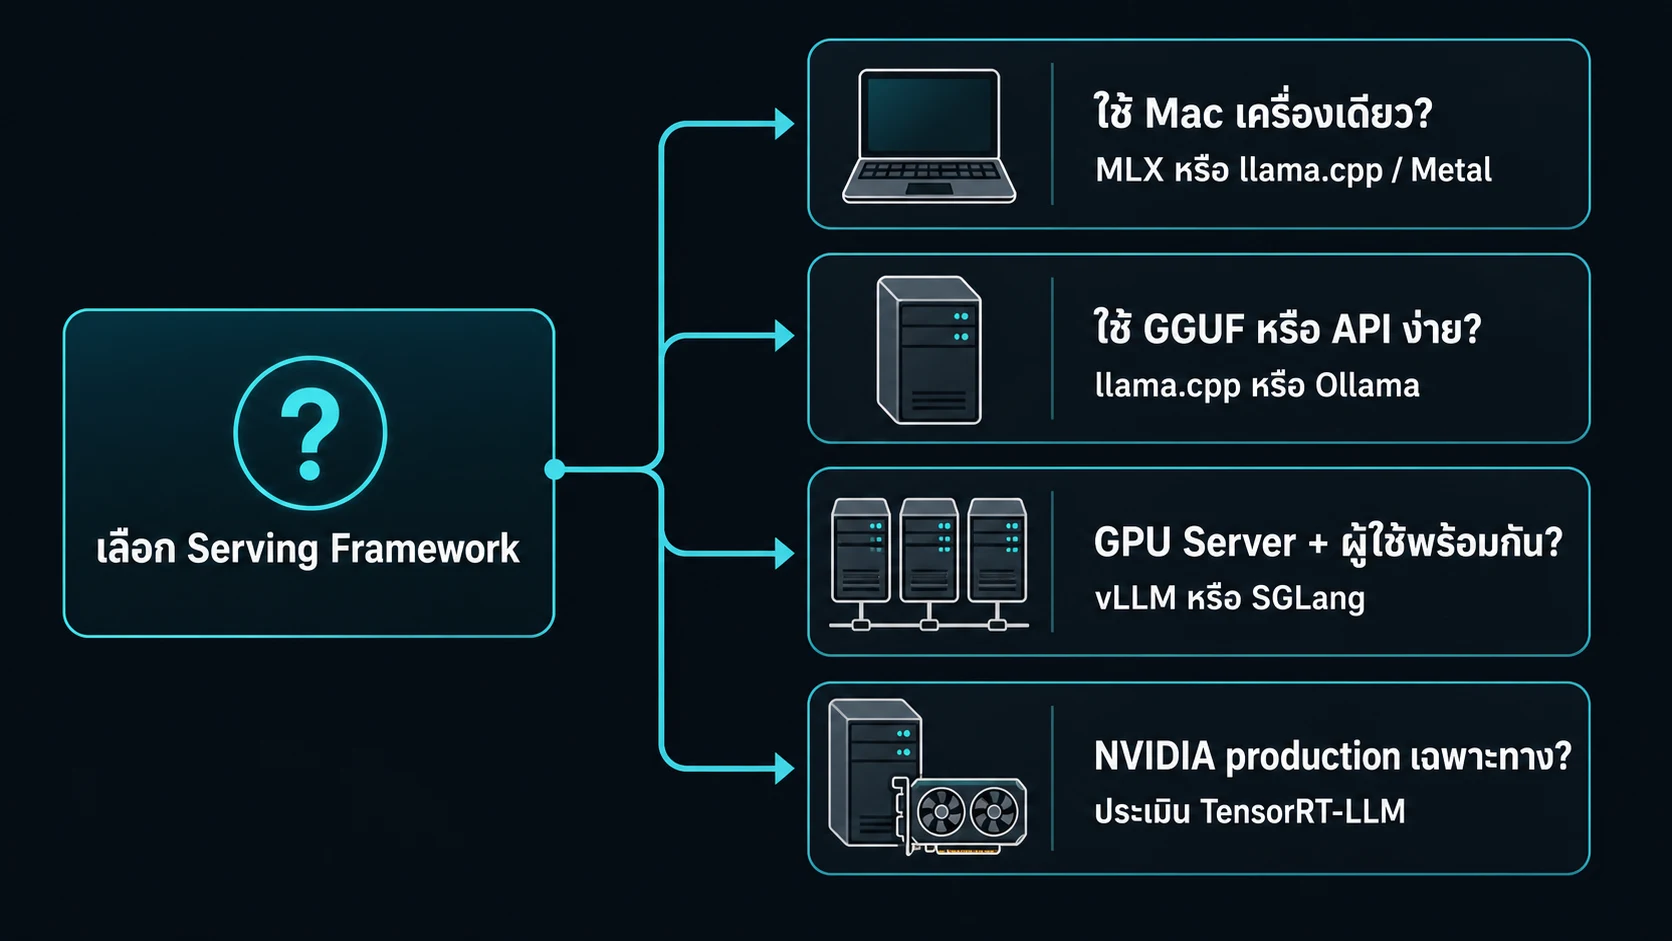
ใช้กับงานจริง
เลือกทาง TensorFold จากตารางรีลีส
เริ่มจากแถวในตารางโมเดลของ README ถ้าไม่มีแถวนั้น ไบนารีรีลีสยังไม่รับเช็กพอยต์นั้น
สูตรชุมชนที่ปัก fork ได้ความสามารถเพิ่ม แต่ตัวเลขความเร็วและสัญญาโทเคนผูกกับกิ่งที่สูตรระบุ
| ทาง | ใช้เมื่อ | สิ่งที่ต้องจด |
|---|---|---|
| รีลีสเนทีฟ | โมเดลมีแถวในตาราง README | รุ่นไบนารี เช่น 1.2.7 และคำสั่ง pull ที่ปักรีวิชัน |
| Mac | แถวนั้นระบุ Metal หรือ MLX | จำนวนเครื่อง บางโมเดลต้องสองเครื่อง |
| NVIDIA | แถวนั้นระบุ CUDA และชิปที่ตรวจแล้ว | ไดรเวอร์ R580 ขึ้นไปสำหรับไฟล์เก็บถาวรปัจจุบัน |
| DeepSeek 2 สปาร์ก | ใช้สูตร Mia ที่ปัก fork | Zig 0.17.0, กิ่ง deepseek-v41-zig, แพ็ก 196 GiB |
| จะอ้าง tok/s | มีตารางเงื่อนไขครบ | นาฬิกา บริบท สตรีม อุณหภูมิ และสถานะดราฟต์ |
ก่อนเปิดเซิร์ฟเวอร์
- ตรวจว่าโมเดลอยู่ในตารางรีลีส หรืออยู่ในสูตรที่ปัก fork ไว้ชัด
- ฟังที่ 127.0.0.1 จนกว่าจะตั้งใจเปิดพอร์ต และใส่คีย์ถ้าเปิด
- จดสถานะดราฟต์ เพราะสัญญาความเท่าของโทเคนเทียบกับร่างที่ปิดดราฟต์บนเอนจินเดียวกัน
- อย่านำ tok/s ของสูตร Mia ไปแทนค่า roofline ในเครื่องคิดเลข
- ถ้าเป็น DeepSeek ให้มีตาราง Engram บนดิสก์ท้องถิ่นของทุกแรงก์
tensorfold serve REPO --host 127.0.0.1 --port 8080 --context 8192 --no-thinkingไบนารีทำอะไรเอง
คำสั่งติดตั้งบน Mac คือ Homebrew สูตร ashhart/tensorfold/tensorfold บน Linux ใช้ไฟล์เก็บถาวรของรีลีส เลือก linux-aarch64 บน GB10 และ linux-x86_64 บนโฮสต์ x86_64 ต้องมี glibc 2.28 ขึ้นไป และไดรเวอร์ NVIDIA รุ่น R580 ขึ้นไปเพราะเคอร์เนลถูกสร้างด้วย CUDA 13 บน Windows ที่มี NVIDIA README ชี้ไปที่คู่มือบิลด์เนทีฟแยกต่างหาก
เซิร์ฟเวอร์ฟังที่ 127.0.0.1 พอร์ต 8080 เป็นค่าเริ่ม มีแชต completions Responses และ Anthropic Messages ชื่อที่โฆษณาให้ไคลเอนต์ตั้งด้วย --name เอกสารยังมี TensorFold Web และแอปเดสก์ท็อปบน Apple Silicon ซึ่งเปิด tensorfold-native ที่มากับแอป
สูตรบางหน้ายังอธิบายเอนจิน Python รุ่น 0.6.6 README บอกให้อ่านส่วนเนทีฟของสูตรนั้นคู่กับบันทึกการเปลี่ยนแปลงปัจจุบัน งานเสิร์ฟของรีลีสจึงอยู่ที่ไบนารี ไม่ได้อยู่ที่สแตก Python เต็มรูปแบบ
สัญญา exact decoding หมายถึงอะไร
หัวข้อ Exact decoding ใน README กำหนดว่าโทเคนดราฟต์ที่รับแล้วต้องเท่ากับโทเคนที่เอนจินเนทีฟตัวเดียวกันจะผลิตเมื่อปิดดราฟต์ คำขอที่ทำต่อต้องเท่ากับคำขอที่รันใหม่ และแต่ละสตรีมที่รันพร้อมกันต้องเท่ากับตอนรันลำพัง การเทียบล็อก checkpoint แบ็กเอนด์ ค่าตั้ง และรันไทม์ไว้ด้วยกัน
คนละ quantization หรือคนละแบ็กเอนด์ผลิตคนละเอาต์พุตได้ สัญญานี้จึงไม่บอกว่า EXL3 ตรงกับ BF16 ทีละบิต และไม่บอกว่า Metal กับ CUDA ให้โทเคนชุดเดียวกันบนคนละฟอร์แมต ธง --no-drafts คือทางผลิตคำตอบอ้างอิงผ่านเอนจินเดียวกัน
ดราฟต์ที่เอกสารผูกกับโมเดลมีทั้งหัว MTP ในเช็กพอยต์ และดราฟต์ภายนอกผ่าน --drafter เช่น DFlash2 ของ Qwen3.8-27B ถ้าไม่ส่งดราฟต์ โมเดลที่ต้องมีดราฟต์ภายนอกจะถอดรหัสแบบธรรมดา
ตารางโมเดลของรีลีสคือขอบเขต
README มีตารางโมเดลที่เส้นทางเนทีฟของรีลีสรองรับ พร้อมคำสั่ง tensorfold pull และขอบเขตเครื่อง ตัวอย่างที่เกี่ยวกับเครื่องในแคตตาล็อกนี้ได้แก่ Qwen3.8-27B แบบ MLX 4 บิตพร้อมดราฟต์ DFlash2, Qwen3.8 Flash Next ทั้งสาย MLX และสาย CUDA, Nemotron 3.5 Lightning ทั้ง MLX 4 บิตและ NVFP4, GLM-5.3-Flash แบบ MLX ที่ต้องใช้ M5 Ultra สองเครื่อง, GLM-5.3-Flash แบบ NVFP4 FP4-Local และ EXL3/TR3 บน CUDA, Qwen3.6-35B-A3B และ Gemma 4
ตารางเดียวกันระบุว่า GLM-5.3-Flash แบบ EXL3/TR3 เป็นเช็กพอยต์ทดลอง ใช้ตัวเลือกแรงก์เนทีฟ ไม่ใช้วิธีติดตั้ง Python บางแถวมีหลักฐาน HIP เฉพาะโมเดล เช่น dots.mocr บน Radeon ที่ตรวจแล้วหนึ่งใบ แถวเหล่านั้นไม่ทำให้ทุกโมเดลในตารางรันบน AMD ได้
บรรทัดที่ต้องอ่านก่อนวางแผน DeepSeek คือข้อความใน README ว่าเช็กพอยต์ DeepSeek ยังไม่ถูกเสิร์ฟโดยไบนารีรีลีสใด และเกตทั้งโมเดลหมายเลข 827 ยังเปิดอยู่ บันทึกการเปลี่ยนแปลงมียงานเคอร์เนล DeepSeek-V4.1 เข้าต้นไม้แล้ว และยังมีจุดที่การเสิร์ฟปฏิเสธบางรูปแรงก์ งานในต้นไม้กับคำว่าเสิร์ฟได้ในตารางรีลีสจึงเป็นคนละสถานะ
สูตร DeepSeek บน 2 สปาร์กปัก fork
สูตร MiaAI-Lab/DeepSeek-v4.1-Flash-1017-2x-DGX-Sparks ไม่ได้เรียก tensorfold serve ของรีลีสทั่วไปกับเช็กพอยต์ทางการ README ของสูตรเขียนว่าเอนจินคือ TensorFold เนทีฟ Zig 0.17.0 ครอบครัว dsv41 ของ BertholomusAI ที่ TP เท่ากับ 2 โดยปัก fork bertholomus/TensorFold กิ่ง deepseek-v41-zig พร้อมแพตช์ของสูตร เครดิตในหน้านั้นแยกงานของ Ash Hart และผู้ร่วม TensorFold ออกจากงานพอร์ต DeepSeek ของ Albert Lee
แพ็กน้ำหนักคือ Mia-AiLab/DeepSeek-V4.1-Flash-1017-EXL3-EAQ-v1-2.9-bpw ขนาด 196 GiB รหัสโมเดลที่ API เสิร์ฟคือ DeepSeek-V4.1-Flash-1017 พอร์ต 8888 มีภาพเข้า เครื่องมือ thinking และ DSpark จากบล็อกในเช็กพอยต์ ค่า HOST เริ่มของสูตรคือ 0.0.0.0 จึงเปิดบนเครือข่ายจนกว่าจะตั้งคีย์หรือเปลี่ยนที่ฟัง แนวของคู่มือเสิร์ฟในไซต์นี้คือฟังที่ 127.0.0.1 ก่อน จนกว่าจะมีเหตุผลให้เปิดพอร์ต
สปาร์กสองเครื่องเครื่องละ 128 GB ที่ต่อด้วย ConnectX-7 คือขอบเขตฮาร์ดแวร์ของสูตรนี้ GLM-5.3-Flash และ Qwen3.8 Flash Next มีสูตร TensorFold ของ Mia แยกต่างหาก อย่าสมมติว่าธงของสูตร DeepSeek ใช้กับทุกครอบครัวในตารางรีลีส
อ่าน 80.7 tok/s ให้ตรงรันที่วัด
ตารางใน README ของสูตร ณ วันที่อ่านหน้านี้ วัดด้วย sparkDash บนคู่เดียว การ์ดทั้งสองเพดาน 2,200 MHz, CONTEXT 524288, ดราฟต์เปิด, หัวเครื่องมีเดสก์ท็อปและคอนเทนเนอร์เล็กประมาณ 18 ตัว ที่หนึ่งสตรีมได้ 80.7 tok/s สำหรับร้อยแก้วอุณหภูมิ 0 ปิด thinking, 63.9 tok/s สำหรับร้อยแก้วอุณหภูมิ 0.7 เปิด thinking, และ 118.1 tok/s สำหรับโค้ดอุณหภูมิ 0 ปิด thinking พร้อม TTFT 133 ms, 214 ms และ 213 ms ตามลำดับ
prefill อยู่ใกล้ 2,100 tok/s ตั้งแต่ราว 4K ถึงราว 256K เมื่อตาราง Engram อยู่บนดิสก์ท้องถิ่นทั้งคู่ จุดที่รายงานคือ 2,105.9 tok/s ที่ 4,114 โทเคน และ 2,065.0 tok/s ที่ 262,163 โทเคน ถ้าตารางถูกอ่านผ่าน NFS รายงานเดียวกันบอกว่า prefill ตกไปราว 690 ถึง 890 tok/s
ข้อควรระวัง หน้านี้ไม่ยกตัวเลขเหล่านี้ไปเป็นความเร็วทั่วไปของ TensorFold เทียบกับ vLLM หรือ mlx_lm เพราะ README ของ TensorFold ไม่ได้ให้การเทียบนั้นภายใต้พรอมต์เดียวกัน นาฬิกาเดียวกัน และสถานะดราฟต์เดียวกัน
เอาไปใช้กับเครื่องคิดเลขอย่างไร
เครื่องคิดเลข llm-cal ประมาณ tok/s จากแบนด์วิดท์และตัวคูณของเฟรมเวิร์ก quantization และ speculative decoding ค่านนั้นเป็น roofline สำหรับจัดลำดับทางเลือก ตาราง 80.7 tok/s เป็นการวัดคนละเครื่องมือบนคู่สปาร์กคู่หนึ่ง เมื่อการ์ดผลลัพธ์ของ TensorFold หรือ EXL3 แสดงความเร็ว ให้อ่านว่าเป็นค่าประมาณของแคตตาล็อก แล้วไปเปิด README ของเช็กพอยต์ที่เลือกถ้าต้องการตัวเลขที่ผู้เผยแพร่วัดเอง
ก่อนเทียบสองทางให้ล็อกโมเดล ฟอร์แมตน้ำหนัก ความยาวบริบท จำนวนสตรีม อุณหภูมิ สถานะดราฟต์ และเพดานนาฬิกาการ์ด ถ้าทางหนึ่งเป็นไบนารีรีลีส 1.2.7 และอีกทางเป็น fork ที่สูตร DeepSeek ปักไว้ ให้บันทึกชื่อกิ่งกับรีวิชันลงในบันทึกการทดลองด้วย เพราะสัญญาโทเคนเท่ากันผูกกับเอนจินตัวเดียวกัน
คำถามที่พบบ่อย
TensorFold ต้องติดตั้ง Python ก่อนเสิร์ฟไหม
เส้นทางเสิร์ฟใน README ปัจจุบันเป็นไบนารี Zig ที่อ่าน checkpoint ตัด token และรันเคอร์เนล Metal หรือ CUDA เอง ตัวอย่าง Linux ปักรีลีส 1.2.7 สูตรเก่ายังพูดถึงเอนจิน Python 0.6.6 ได้ แต่คำสั่งติดตั้งของรีลีสไม่ต้องมี Python หรือ MLX ในเส้นทางเสิร์ฟ
รีลีส TensorFold เสิร์ฟ DeepSeek-V4.1 แล้วหรือยัง
README ที่อ่านเมื่อ 2026-11-12 บอกว่าไบนารีรีลีสยังไม่เสิร์ฟเช็กพอยต์ DeepSeek และเกต 827 ยังเปิดอยู่ สูตรสองสปาร์กของ Mia ปัก fork ของ BertholomusAI กิ่ง deepseek-v41-zig พร้อมแพตช์ของสูตรบน Zig 0.17.0 จึงเป็นคนละไบนารีกับคำสั่ง tensorfold serve ของรีลีสทั่วไป
แหล่งอ้างอิง
ลองกับ configuration ของคุณ
นำ model, quantization, context, framework และ hardware ที่คิดไว้ไปลองใน calculator จากนั้นยืนยันด้วย benchmark ที่ใกล้ production
เปิดเครื่องคำนวณ